 devgo.cn
实时视频生成和离线生成是两种完全不同的工程问题。离线生成时,用户提交 prompt 后排队等待,后端慢一点没关系,用户只是多等几秒。但实时世界模型没有等待区——每一段新生成的视频和同步音频,必须赶在观众看完上一段之前渲染完毕,否则画面就卡住了。这不是吞吐量问题,而是硬性延迟 SLO(服务等级目标,即每一步必须在规定时间内完成)。Visko 这家做交互式世界模型的 AI 创业公司,和 Google Cloud TPU 工程师合作,把它的旗舰模型 Orbis 的完整实时推理管线——视频扩散、超分辨率放大、音频生成——全部塞进单个 TPU slice(TPU 切片,即一组通过高速互联绑定的 TPU 芯片),最终做到 1.07x 播放速度的实时渲染,从启动到生产交接只用了 30 天。
为什么实时世界模型这么难?两个结构性约束让它和常规批量推理完全不同。第一,batch size 为 1。每个直播流代表一个独立观众的交互会话,你没法把几十个并发请求凑成一个大 batch 来掩盖延迟——这是让 AI 加速器保持饱和的常规做法,在这里行不通。第二,严格的顺序依赖。每一块视频 chunk(视频片段)都直接依赖前一块,因为视频模型维护着最近视频 latents(潜在表示,即扩散模型在压缩空间中的中间特征)的滚动记忆,让第 N+1 块能平滑衔接第 N 块的动作。你没法预渲染乱序的 chunk,也没法跨未来时间戳做并行。对从 LLM serving 转过来的基础设施工程师来说,别把实时世界模型当成 tokens-per-second 的吞吐量基准,要把它想成一个毫不留情的每步延迟 SLO。
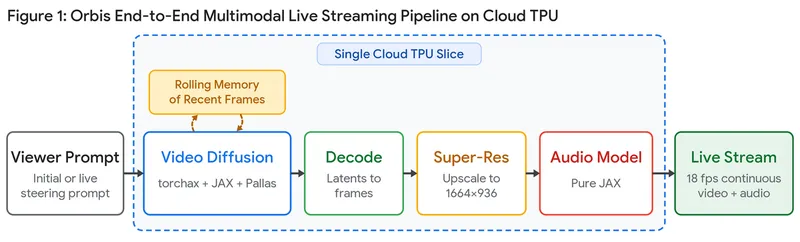
Visko 的管线设计思路是:为了保持基础设施精简和成本可控,把三个不同的生成模型串在单个 Cloud TPU slice 上,用 BF16 精度(一种半精度浮点格式,比 FP32 省一半内存,速度更快)运行。观众提交初始 prompt 或实时转向指令后,核心视频扩散模型、超分辨率放大器和音频生成器共享同一批芯片,轮流处理每个 chunk。
软件栈建立在三个开源支柱上:JAX(Google 面向加速器的高性能 Python 数组库,由 XLA 编译器编译成优化机器码)、torchax(一个互操作层,让 PyTorch 模型能直接通过 JAX 跑在 Cloud TPU 上,创业团队不用从头重写)、Pallas(JAX 里 TPU 的自定义 kernel 编程语言,相当于 GPU 上写自定义 Triton 或 CUDA kernel)。
真正让性能达标的是三个关键优化。第一个是 Ulysses context parallelism(一种上下文并行策略,把序列切分到多块芯片上)。视频 chunk 在视频 transformer 内部会展开成巨大的时空 token 序列。为了在 batch size 为 1 时把负载分布到多块 TPU 芯片上,团队没有拆分模型权重,而是把 token 序列切分到各芯片。在 attention 层之前,通过高速 all-to-all 互联交换重新组合张量,让每块芯片持有完整视频序列,但只负责四分之一的 attention heads(注意力头,即多头注意力机制中每个独立的注意力计算单元)。每块芯片算完自己负责的 heads 后,第二次 all-to-all 交换恢复序列切分布局,供 feed-forward 层使用。
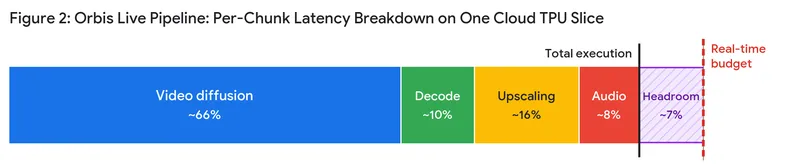
第二个是来自 MaxDiffusion 的自定义 Pallas splash attention。视频去噪占了总计算预算近三分之二,所以这个阶段成了 kernel 和并行优化的主战场。团队没有用现成的 attention 实现,而是为 TPU 写了定制 kernel,针对实时推理的访问模式做了专门调优。第三个优化是纯 JAX 的音频生成。音频生成器完全用 JAX 重写,没有依赖任何第三方推理框架,这样就能和视频管线共享同一个编译图,避免跨框架调度的开销。
最让我意外的是整个项目只用了 30 天。Visko 从 PyTorch 原型起步,通过 torchax 把现有组件直接跑上 TPU,再用 Pallas 写自定义 kernel 优化热点,最后把三个模型串在单个 slice 上。这种从原型到生产的路径,对创业团队来说非常现实——不用一开始就做全量重写,而是先跑通再优化。整个管线在 BF16 下每 chunk 延迟低于目标,还留了约 7% 的余量来吸收直播中的波动。
这套思路能直接用到哪些场景?凡是涉及实时交互式生成的任务都适用:AI 陪伴、直播电商、沉浸式教育、机器人仿真,以及任何需要低延迟多模态输出的产品。要注意的坑是:别把实时生成当成吞吐量问题来优化,batch size 为 1 时传统的高吞吐策略全部失效;也别一上来就追求全量重写,torchax 这种互操作层能让你先跑通再逐步替换热点;另外,单 slice 部署虽然成本低,但要注意留出延迟余量,直播场景的波动比离线推理大得多。
内容与图片版权归原作者所有 · 原文: https://cloud.google.com/blog/products/media-entertainment/how-visko-streams-real-time-world-models-on-google-cloud-tpus/