 devgo.cn
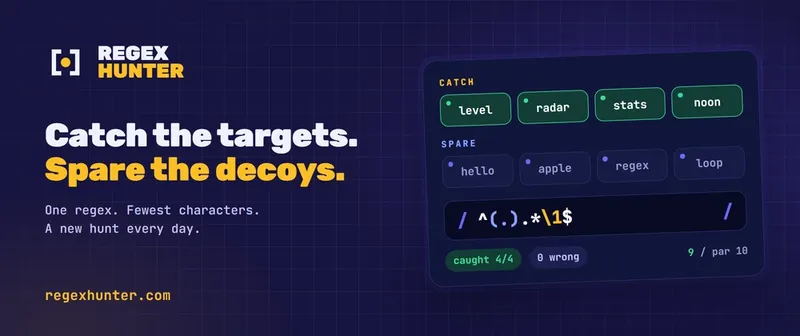
如果你玩过正则高尔夫(用最短的正则表达式完成匹配任务),大概体会过那种“差一个字符就完美”的纠结。作者把这个玩法做成了每日游戏 Regex Hunter,每天一道题,所有人用同一个模式去匹配目标词、避开干扰词,然后比谁写得更短。但真正让他头疼的不是出题,而是“怎么给正则公平地计分”。
先说最基础的:长度就是分数,但“长度”怎么定义?在 JavaScript 里,`'😀'.length` 是 2,因为 JS 按 UTF-16 码元计数,一个 emoji 占两个码元。如果直接拿这个当长度,那用 emoji 写正则的人就白吃亏了。所以客户端用 `[...pattern].length` 按码点(Unicode 字符的真正数量)计数,服务端用 Python 的 `len()`,两者天然一致。
然后是 flag(修饰符)的计费。`/i`(忽略大小写)这种 flag 会改变匹配行为,必须收费,否则一道大小写不敏感的题就会被 `i` 直接废掉。作者规定,除了题目自带的 flag,每加一个 `i`、`m`(多行模式)、`s`(点号匹配换行)都算一个字符。但 `g`(全局匹配)不收费,因为对“是否匹配”这个判断来说,`g` 没有影响。
计分还有个“标准杆”(par)的概念,类似高尔夫。每道题设一个“不错但不神”的解法长度作为 par,得分是 100 × par ÷ 你的长度,上限 150。设上限很关键,否则一道简单题上偶然发现的 3 字符奇技淫巧,能抵过一周的稳定发挥。社区题目(用户自己出的题)的 par 还有额外限制:不能超过当前最短解法的 1.5 倍,防止出题人故意放水刷分。
浏览器端实时校验用 JavaScript 的 RegExp,每次击键都跑一遍,反馈要快。但排行榜不能信浏览器,所以每次提交的解法都要在服务端用 Python 重新验证。服务端校验有两个浏览器没有的职责:一是限制模式最长 64 字符,够用且能控制计算量;二是防灾难性回溯(catastrophic backtracking,指某些正则模式在特定输入下会指数级消耗时间)。有人会故意提交 `(a+)+$` 这种模式去拖垮服务器,作者用 Python 的 `regex` 模块给每个词设了 25 毫秒超时,超时就算匹配失败,而不是服务器错误,这样恶意模式最多消耗一次请求。
写这篇文章时作者还发现了一个隐蔽 bug:浏览器端的校验代码用 `new RegExp(pattern, flags)` 然后对每个词调用 `regex.test(w)`。如果 flags 里带 `g` 或 `y`,`test()` 就变成有状态的——匹配成功后 `lastIndex` 会记住上次匹配结束的位置,下一次调用(哪怕换了个字符串)会从那个位置开始搜。比如先匹配 `cat` 成功(结束于索引 2),再检查 `car` 时从索引 2 开始,找不到匹配,于是明明正确的模式被判为漏掉目标。虽然当前每日题没用 `g`,但编辑器允许,修复只需一行:每次测试前把 `lastIndex` 重置为 0。作者还补了个测试防止回归。
除了核心计分,作者还做了几个影响公平性的小决定:回放历史题目不影响连续签到(那是练习不是重考);排行榜按正则概念分开排(锚点、字符类、量词、反向引用、环视),避免一个总分掩盖真实水平;多人模式分三种——最短(字符数最少赢)、最快(最快解出赢)、盲打(只给棋盘不给描述,盲写正则)。
游戏本身还有每日题、练习阶梯、交互式教程、社区出题、实时多人对战等功能,支持中英双语,每日题免费且无需账号。
这个项目最值得借鉴的不是正则本身,而是“给一个看似简单的指标(长度)做公平性设计”的完整思路。如果你在做任何涉及用户提交代码、表达式、查询并需要评分的系统,这里有很多坑可以提前避开:跨语言字符计数的一致性、flag 是否收费、超时怎么算、状态性 API 的隐蔽陷阱、社区内容的防作弊上限。特别是那个 `g` flag 的 bug,提醒我们:一个看起来是布尔判断的 API,底层可能是个迭代器,这种“穿着布尔外套的迭代器”在任何语言里都可能咬你一口。
内容与图片版权归原作者所有 · 原文: https://dev.to/mrdebugger/i-built-a-daily-regex-game-scoring-regex-fairly-was-the-hard-part-52h9