 devgo.cn
一个企业客户在 AWS 上管着 300 多台 Linux 和 Windows 实例的灾难恢复,在准备一次计划内演练时撞上两个问题:一部分代理在网络变更后卡死了;另一部分已经移出 DR 范围的服务器还在复制、还在计费。
第一个问题的杀伤力在于沉默。代理卡住的机器达不到 RPO(恢复点目标,即最多能接受多少数据丢失),但团队只在每次演练前才去控制台看复制状态,两次演练之间发生的事根本发现不了。第二个问题则是纯粹的钱:没人记得去卸,账就一直往外走。
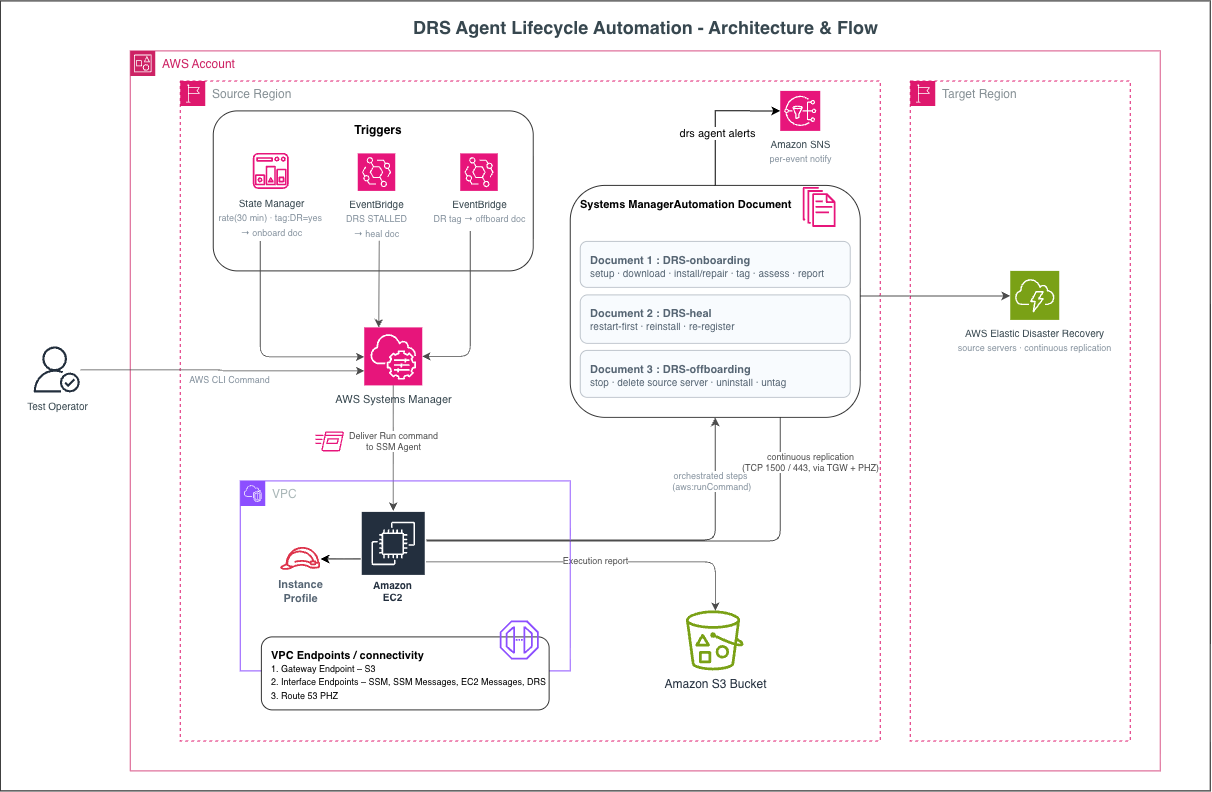
AWS 的这篇架构博客给的做法是,把整个生命周期收进三份 SSM Automation 文档,用实例上的一个标签决定走哪条路。
一个标签,四种状态
标签名是 `DR`,值只有三种合法取值,另外所有非法值都会被安全地忽略:
- `yes`:受保护。装代理、打上 failback 标签、每 30 分钟做一次健康检查。
- `pause`:静默。代理保留,告警抑制,禁止下线——适合演练窗口或临时排查。
- `no` 或直接删掉标签:退出范围。停复制、删源服务器、卸代理、清标签。
- 其他任何值(比如 `DR=maybe`、`DR=true`):配置错误。跳过并记一条 `SKIPPED_MISCONFIGURED`,什么都不做。
最后这条是整套设计里最容易被忽略、也最该抄的一条:宁可不动,也不要因为一个拼错的值触发错误的动作。值在判断前会先 trim 再转小写,所以 `DR=Yes` 能正确匹配。
三条触发路径
- **Onboarding**:State Manager 每 30 分钟对 `tag:DR=yes` 的实例跑一次。装或修代理,确认注册状态。它是幂等的,健康的实例直接跳过;`MaxConcurrency` 设 10、`MaxErrors` 设 100%,意味着一台失败不会拖停全队。大规模环境要慢慢加并发,同时盯 DRS API 限流。
- **Healing**:DR 区域检测到复制停滞后发出事件,经 EventBridge 跨区转发回源区域,匹配 `STALLED` 状态才触发。先重启代理服务——大多数停滞是瞬时的;重启无效才原地重装,且不先卸载,尽量保住复制驱动状态,避免全盘重扫。重扫耗时随磁盘容量增长,大卷上有可能临时超出 RPO 窗口。
- **Offboarding**:标签变更或删除触发。先做三重保护:复查标签、检查实例是否已终止、可选的审批门。通过之后记录复制状态再停,然后断连、删源服务器、卸代理、清标签。
三层保 RPO,各管一段
客户自定的目标是 15 分钟,注意这是配置目标,不是 AWS 的服务承诺。架构上用三层互补:
1. **操作系统层(秒级)**:Linux 用 systemd 的 `Restart=always`,Windows 用服务恢复策略。进程崩了系统自己拉起来,不需要任何自动化参与。
2. **EventBridge 自愈(分钟级)**:代理消失或维持不住注册时,DR 区域发出停滞事件,跨区转发后触发修复。这一层依赖两个区域的 EventBridge 数据面都在线。
3. **State Manager 兜底(最长 30 分钟)**:定期重新评估,抓漂移和边角情况。它超出 15 分钟目标,所以定位是安全网,不是主防线。
还有一条分界很重要:不是所有停滞都是代理的锅。带宽限流、复制服务器规格不足、暂存盘空间不够,都会表现成停滞。自动化只处理代理侧故障,其余的直接通过 SNS 升级给人,而不是硬修——修错了只会掩盖真问题。
下线要给出"诚实的计费状态"
这套方案在退出范围时会记录复制计费是否真的停了。这个细节看着小,其实是整个自动化的价值所在:它把"我以为已经不在保护范围了"和"实际上还在跑、还在收钱"之间的缝隙堵上了。
本质上,这是把"某台机器是否在 DR 范围内"从一个需要人记住的状态,变成了一个声明式的标签。声明式的好处不是省事,而是让沉默的偏差变得可见。
内容与图片版权归原作者所有 · 原文: https://aws.amazon.com/blogs/architecture/automating-the-full-aws-drs-agent-lifecycle-install-heal-and-offboard/