 devgo.cn
数据治理最常见的尴尬是:真正要紧的上下文不在 S3 里。一个对象属于什么密级、适用哪条留存策略、数据允许停在哪个区域、里面有没有个人信息——这些答案通常躺在另一个数据库里,跟它描述的对象隔着一整套系统。对象一多,两边就开始对不上:对象删了记录还在,记录改了对象没跟上,审计时谁也说不清哪份是准的。
S3 注解(annotations)想消掉的就是这一层距离。它允许把治理上下文直接挂在对象上,**不用重写对象本身**。容量上给得很宽:单个对象版本最多 1000 条注解,每条是 1 字节到 1 MB 的 UTF-8 负载,JSON、XML、YAML 或纯文本都行。这意味着你放的不只是几个键值对,而是一份完整的治理记录。
跟着对象走,而不是跟着系统走
注解存在对象版本上,所以复制和跨区域复制会把注解一起带走——灾备副本上的密级标签和驻留标签不会丢。对象进了 Glacier Flexible Retrieval 或 Deep Archive 之后,注解依然可以直接读,不需要先发起还原;计费按 S3 Standard 费率算,跟父对象的存储类无关。这一条对合规场景很实用:审计要查一份五年前的归档合同适用什么留存策略,不用等几小时解冻。
需要注意一个设计取舍:一次 `PutObjectAnnotation` 只写一条具名注解。你可以把整份记录塞进一条(文章里的例子叫 `governance-context`),也可以拆成多条细粒度注解。拆开的好处是更新某个字段不用重写其余部分,误覆盖的影响被限制在单个字段,还能在注解表里按更细的粒度查询;合成一条的好处是每次读写只走一个操作,记录内部天然一致,不存在多个名字之间的半更新状态。文章选了一条,理由很明确:这份记录本来就是整体写入、整体消费的。
更新的成本几乎为零
对象被重新定密或复核后,流程用 `PutObjectAnnotation` 原地更新注解。分类变了,对象不用重写,ETag 也不变。这一点比想象中重要:如果靠复制对象来改元数据,每次改动都是一次全量数据传输,还会打断下游基于 ETag 的缓存与去重。原地更新同样是可复制的,源端改了密级,跨区域副本的上下文会自动跟上,前提是复制角色带着注解复制权限。
读写路径与规模化查询
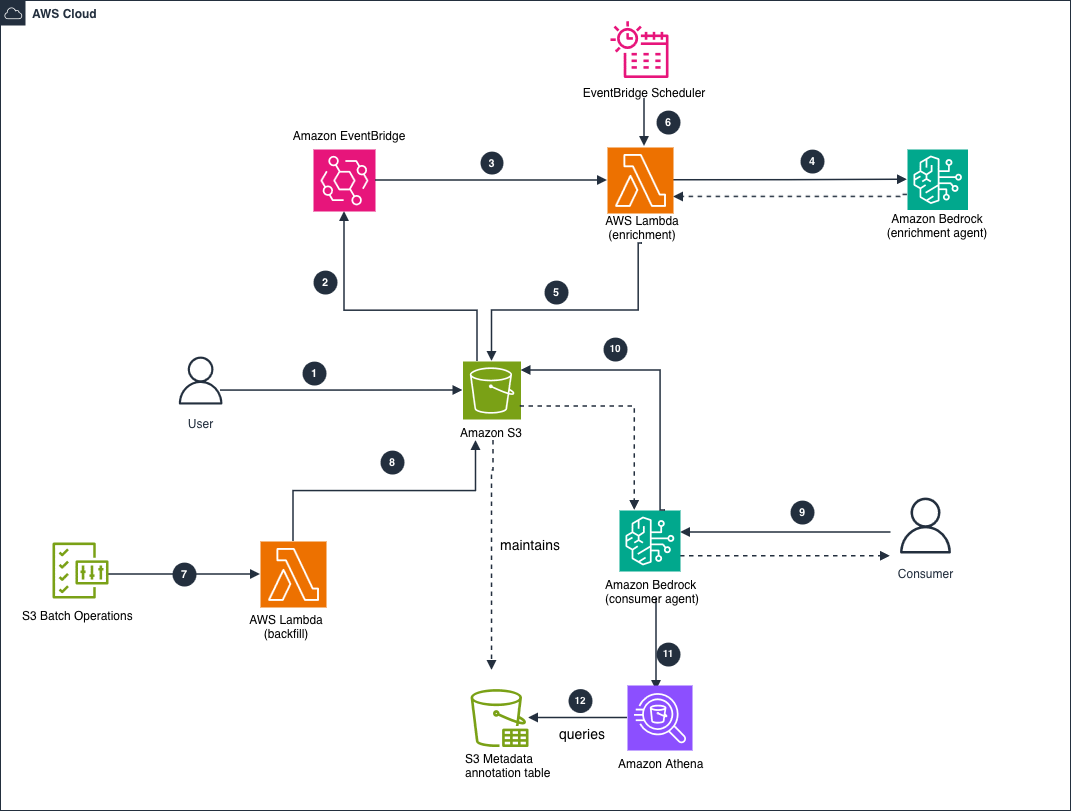
写入侧是一个事件驱动闭环:生产者 `PutObject` → EventBridge 发出对象创建事件 → 触发 Lambda → Lambda 调 Bedrock 的 enrichment agent 做分类、抽取留存/属地/PII → 校验后写注解。文章特意提醒了一句:模型经常把 JSON 包在 Markdown 代码围栏里,写之前必须验证能解析且符合 schema,因为注解负载要的是裸的结构化文档。写到对象上之后又会发出 `s3:ObjectAnnotation:Put` 事件,下游可以继续订阅。
走 EventBridge 而不是直接让 S3 调 Lambda,换来的是按前缀、对象大小过滤事件的能力,以及同一事件多目标分发而不用改桶配置;如果不需要这些,直接通知或 SQS 更简单。
读取侧分两档。少量对象,只要有只读注解权限,列一下、取一下就够,**不需要读对象,也不需要另一个治理库**。规模大了,就开启 S3 Metadata 注解表:给桶配一个元数据配置,指定 S3 可 assume 的 IAM 角色(信任 `metadata.s3.amazonaws.com`),S3 会在 S3 Tables 里维护一张 Iceberg 表,用 Athena 一条 SQL 就能跨全桶查。文章给的例子是「哪些对象含 PII 且留存已过期」:
```sql
SELECT object_key, object_version_id
FROM "s3tablescatalog/aws-s3"."b_amzn_s3_demo_governance"."annotation"
WHERE name = 'governance-context'
AND json_extract_scalar(text_value, '$.pii.present') = 'true'
AND json_extract_scalar(text_value, '$.retention.status') = 'expired';
```
代价是最终一致:表是异步填充的,首次回填按对象量可能几分钟到几小时,查询结果反映的是最近一次刷新(通常一小时以内)的状态,不能当实时数据用。
老对象怎么办
已经存在的对象需要单独一趟回填,用同样的 `PutObjectAnnotation` 批量打标。于是整个架构自然分成四条路径:新对象写入时富化、复核后维护、存量回填、消费者只读注解。这四条路最好在画架构图时就分开画,否则很容易出现「新对象有标签、老对象没有」的半治理状态——而那恰恰是审计最容易挑出来的问题。
小结
这套方案真正的价值不是「S3 多了个元数据字段」,而是**把治理上下文的所有权从外部系统挪回数据本身**,顺带解决了复制、归档、更新三件麻烦事。落地时三个决定要提前想清楚:一条注解还是多条、回填怎么跑、查询能不能接受一小时延迟。想清楚这三条,剩下的就是普通的事件驱动工程。
内容与图片版权归原作者所有 · 原文: https://aws.amazon.com/blogs/architecture/data-governance-with-annotations-in-amazon-s3/