 devgo.cn
你向 Prometheus 查一个具体的标签组合,它背后存着一千万条活跃时间序列,但响应只要几毫秒。更关键的是,它从头到尾没有遍历全部一千万条数据,连跳过哪些数据都是靠索引直接决策的。数据规模与查询实际触及量之间的这道鸿沟,正是这篇文章要讲透的故事。我顺着 TSDB 源码挖了一遍,发现这个能力是由三层思想叠加出来的,而且真实代码里的几个细节比教科书版本更聪明。下面从最底层开始拆解,所有结论都对应实际代码,不是空谈。
先明确一个基础概念。在 Prometheus 中,一条时间序列就是一组标签附上一个整数 ID。标签描述事物,ID 是内部名字。例如 `{job="api", pod="web-1"}` 映射为 #1,`{job="api", code="500"}` 映射为 #2。当你发起查询时,索引的唯一任务就是根据标签条件返回匹配的 ID 集合。后续抓取样本、做 PromQL 计算都发生在你拿到这个集合之后。所以整个性能问题归结为:如何从标签快速走到 ID?
最容易想到的设计是正向映射:每条序列指向自己的标签。要回答 `{job="api"}`,就遍历所有序列逐一检查。这个方案在一开始能工作,但规模一大立刻崩溃。每次查询都要检查全部序列,成本随总序列数增长,而不是随实际匹配数增长。一千万条序列就意味着一千万次检查来回答一个小问题。这就是没有索引的 grep:小文件没问题,大文件无望。关系数据库会建 B-tree 索引而不是全表扫描,Prometheus 也做了同样的选择,只是针对自己的数据形态做了调优。

Prometheus 用的是倒排索引。想象教材末尾的索引页:你不会翻遍 600 页找“线粒体”出现在哪里,而是翻到末尾查词条,它直接列出页码。Prometheus 正是如此。它不再从序列映射到标签,而是从每个 `label="value"` 映射到拥有该标签的序列列表。这个列表叫 postings list。在内存 head block 中,整个结构叫 MemPostings,本质是一个 `map[labelName]map[labelValue][]SeriesRef` 的嵌套 map。从 `job="api"` 到 [1, 2, 4] 只需几次 map 查找,扫描零条序列。这个数据结构正是 Lucene、Elasticsearch 以及几乎所有搜索引擎背后的东西。倒排索引是那种悄悄运行在你接触的一半软件里的思想。
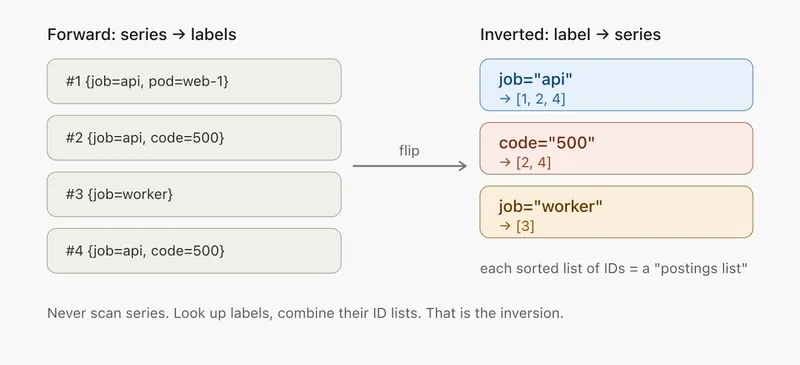
这里有个后面会起作用的细节:这些列表按序列 ID 排序存放,Prometheus 刻意维持这种有序性(代码里有专门的 EnsureOrder 步骤在多个 worker goroutine 间排序)。排序不是偶然,排序是让下一步变便宜的前提。
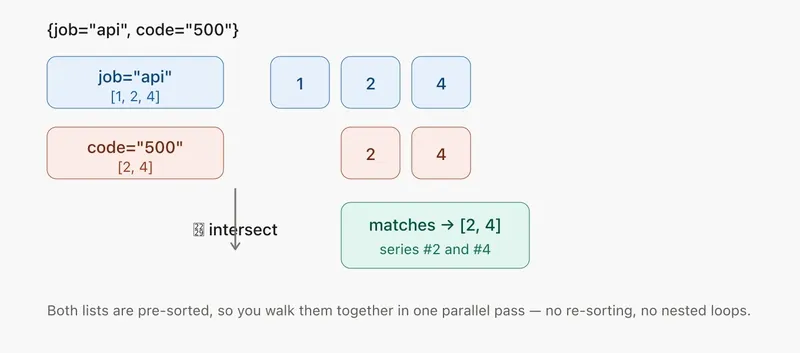
当每个标签都能给出一个排序后的 ID 列表,多条件查询就变成了集合运算。比如 `job="api" AND code="500"`,取两个 postings list 找公共 ID。最朴素的双指针走两个有序列表:两个指针同时移动,指向相同 ID 就是匹配,否则推进较慢的那个。一次线性扫描,没有嵌套循环,不需要重新排序。
但真实代码比双指针更聪明,这个差异正是“稀有标签在巨型列表下依然便宜”的核心原因。`intersectPostings.Next` 的实际逻辑是:先推进所有列表一次,取当前最大 ID 作为目标值,如果列表还没对齐,就对所有列表调用 `Seek(target)`,让每个列表直接跳到第一个不小于目标值的 ID,而不是一步步走。在磁盘上,这个 Seek 是二分查找而不是线性扫描。持久化的 postings 以定长大端序 uint32 存储,所以 `bigEndianPostings.Seek` 可以直接用 `sort.Search` 二分定位。
为什么这很重要?如果你要取一个小列表(比如 `code="500"` 只有十条)和一个大列表(`job="api"` 有一百万条)的交集,交集由小列表主导:对十条 ID 中的每一个,在大列表里做一次二分查找,而不是遍历它。对一百万条目做十次二分查找几乎毫无成本。定长大端序编码就是为了让这种随机访问式二分查找成为可能。排序加 Seek 是机制,双指针只是便于理解的口水版。
所有 PromQL 匹配器,在底层都归结为三种集合运算之一。AND 是“同时在两个列表”(intersect),OR 是“任一列表”(union),NOT 是“在第一个但不在第二个”(subtract)。三者都是对有序输入做一次近似线性的扫描。但 NOT 藏着一个另外两个没有的问题:从哪里减?“没有 `code="500"` 的序列”必须相对于某个全集才有意义。Prometheus 的解法是维护一个特殊 postings list,键是空标签 `{}`。每条序列在加入索引时,既注册到真实标签下,也注册到这个空键下。于是永远存在一个包含所有序列 ID 的 all-postings list,NOT 就是全量减去匹配列表。
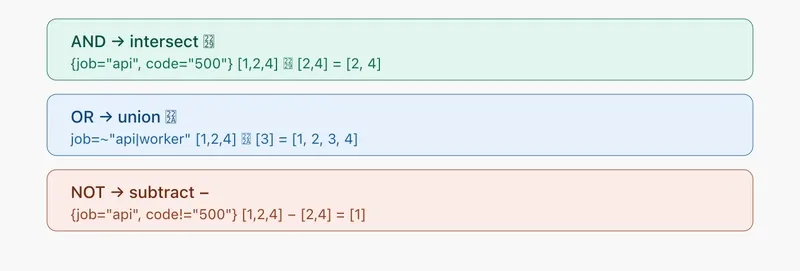
比 AND 更棘手的部分出现在负向匹配器。考虑 `{job="api", instance!="host-1"}`。你不能简单地对两个列表做交集,因为 `instance!="host-1"` 也必须包含那些根本没有 instance 标签的序列——缺失也算匹配否定。所以负向匹配器不能是交集,必须是从更大集合里做减法。`PostingsForMatchers` 把匹配器分成两组:需要交集的(构造基础集)和需要减去的(否定与匹配空字符串的)。先算正向匹配器的交集,再对每个负向匹配器做 Without。源码里有两个漂亮的细节:第一,它会故意把待交集的匹配器排到前面先执行,这样做减法时基础集尽可能小,成本更低,也规避了查询中途新增序列带来的一致性隐患;第二,如果查询只有负向匹配器(比如 `{job!="api"}` 没有任何正向条件),没有东西可以交,那就直接从 all-postings 开始减。
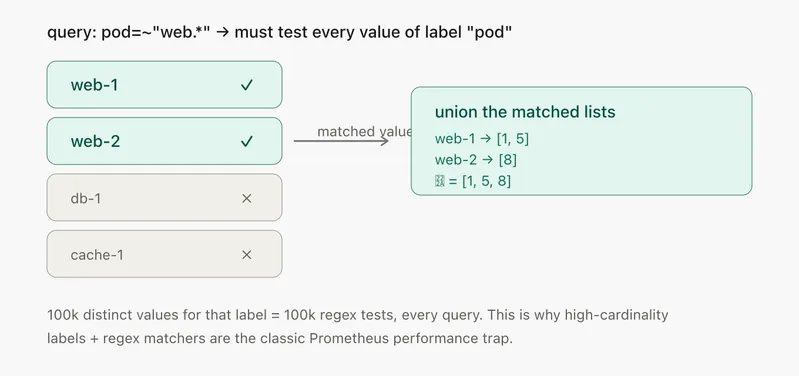
这三层设计——倒排索引把标签映射到有序 ID 列表、有序列表让集合运算可以二分跳跃、空标签全集让否定运算有意义——叠加起来,就是 Prometheus 能在千万级序列下毫秒级回答标签查询的全部秘密。最让我意外的是,这个思路不止适用于时间序列数据库。任何需要在大规模离散枚举值上做快速过滤的场景,都可以借鉴:全文搜索、事件日志分析、权限系统(用户匹配角色与资源标签)、甚至云原生里的服务发现。值得注意的坑是,倒排索引的代价在写入侧:每条新序列要更新多个 postings list,且要维持有序性。写放大是必须接受的,Prometheus 用 head block 的内存分批写入和后台持久化来缓解。如果你在给自己设计类似索引,优先保证有序性,因为有序直接决定了后续集合运算能否用二分跳跃。没有有序,倒排索引就退化成一堆需要全扫描的桶,性能优势荡然无存。
内容与图片版权归原作者所有 · 原文: https://dev.to/v4nd1t/how-prometheus-finds-matching-series-in-milliseconds-2jno