 devgo.cn
核心观点
- Agent 拥有杠杆,杠杆带来义务:必须有人能解释「改了什么、为什么安全、错了会怎样」——否则行动无法被正当化,组织也不会托付给它。
- 三个核心概念:Quality(放系统上线前安装的所有检查,产生证据)、Verdict(证据进入依赖系统前的最终决策:发布/拦截/改道/收窄/加护栏/拒绝)、Answerability(被问到时能解释「为什么」的保证)。
- 系统内部只有一种东西:capability(模型调查、实现、测试、汇报的能力);系统外部只有一种:agency(决定、验证、批准、拥有的权力)——工程师拥有外层循环。
- 数据现实:Sonar 2026 报告显示 42% 的提交代码由 AI 生成或显著辅助;生成速度被推快,而控制速度没跟上——形成「信任-验证缺口」。
内容精讲
过去一年,Agentic 工程的讨论已经推进到 harnesses、loops、fleets 与 software factories。这篇文章提出一个在喧闹中最容易被忽略的论点:工程师需要拥有外层循环——对这些系统的问责。随着 Fable、GPT-5.6 这类更强模型的到来,这一点只会更真。
**杠杆创造义务。** 如果没有任何人能解释「到底改了什么、为什么安全、如果错了会发生什么」,Agent 的行为就无法被正当化,组织也不太可能要求它们承担重要工作。所以职责必须落在人身上,不是系统上。这带来三个概念。Quality 指我们放行系统之前安装的所有检查——这些检查产生证据;Verdict 指证据进入我们依赖的系统之前的最终决策——「我是这批内容的总制片人,模型可能写出那行字,但 Verdict 是我的」;Answerability 指保证——如果有人问,我能解释为什么。
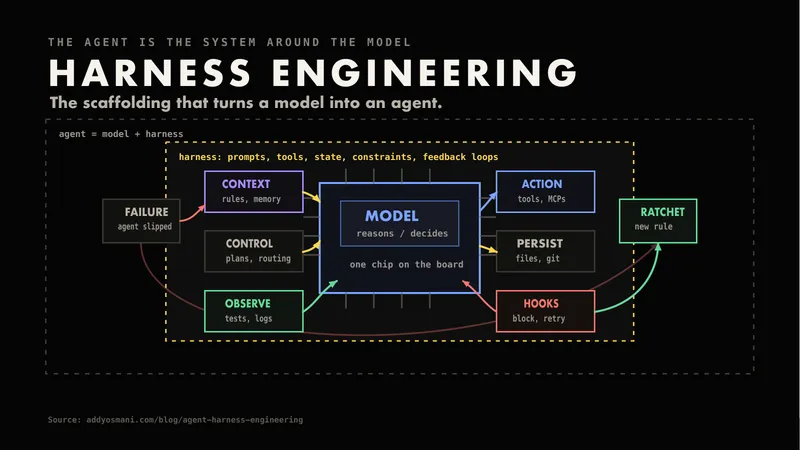
**系统内外的两分法。** Agent(模型 + harness:文件、工具、记忆、技能、沙箱、权限、可观测性、恢复能力)运行 loop(调查-实现-验证-重复),loop 构成 software factory。工厂的边界很关键:边界内,Agent 做的是 capability——调查任务、实现计划、验证结果、汇报;证据跨过边界;边界外,拥有依赖系统的人看到证据并决定是否继续——那是 agency。模型只是引擎,harness 是围绕引擎造的车,loop 是让一次好运行变成可重复信任流程的机制,factory 是并行的 loop。边界内的自动化与边界外的人的裁决,这个分工就是「拥有外层循环」的含义。
**生成的便宜与控制的稀缺。** Sonar 2026 调查显示 AI 辅助提交占比已不小,受访者预期将大幅增长;State of Code 报告给出 42% 的提交代码由 AI 生成或显著辅助。创建越来越便宜,真正稀缺的资源变成了评审、验证、理解与维护。我们移动生成速度的速度快于移动控制速度的速度——于是有了信任-验证缺口:很多人说对 AI 代码不信任,但很少人把这种不信任系统化地建进验证流程。GitLab 2026 年 6 月的 AI 问责研究也显示:评审与验证是使用 AI 时当前的瓶颈,更令人担忧的是治理通常发生在代码创建之后——在风险已被接受、所有权已失控之后。
**Quality 是背压,不是放任。** 我们不打算给 Agent 尽可能多的自主权,而是给「刚好够」的自主权,从而保有足够背压来拦截、约束、检查它们的工作、保住人性。普通工程已经挂起大量信号:类型检查、测试、hooks、沙箱限制、审计日志、监控器——这些信号提供背压让系统保持诚实。只要 Agent 持续发出同样的信号,普通工程就能提供恰当的背压。信任系统不意味着不想看到人在回路里——而是意味着把人的注意力集中在最该用的地方:证据的裁决与问责。
阅读价值
对工程管理者与质量负责人,Quality/Verdict/Answerability 三件套提供了一个清晰的责任框架,42% 的 AI 代码份额让「何时验、谁裁决」成为必须回答的问题;对一线工程师,capability/agency 的边界划分回答了「我的职责还剩什么」——拥有外层循环,是 Agent 时代不可让渡的工作。
内容与图片版权归原作者所有 · 原文: https://addyosmani.com/blog/own-the-outer-loop/