 devgo.cn
你所在公司的合规团队发现支付清算越来越慢,怀疑有欺诈,需要你这位数据科学家帮忙找出优先排查的交易。以往的做法是:写脚本清洗原始交易日志,训练一个欺诈分类模型,对新增交易打分,最后把可疑记录排成队列,还得每天手动重跑一遍。这套流程琐碎且重复,大部分时间耗在“搬数据”和“调管道”上,真正处理问题的精力被挤占。现在,Google 推出的 Data Agent Kit 试图把这整条链路塞进 IDE 里,用自然语言指挥一个 Agent 完成从数据加载、清洗、建模到调度部署的全部工作。
先说清楚它是什么。Data Agent Kit 是一个帮助你在 Google Cloud 上操作数据的工具包,可以装成编码 Agent 的插件,或者基于 Visual Studio Code 的 IDE 扩展。它带来两类东西:一类是 MCP 工具(让 Agent 能调用外部数据服务的标准协议接口),把 Agent 连接到数据服务;另一类是 Skills——Markdown 格式的指令文件,里面写着操作你数据栈的最佳实践和步骤。同时,它直接在编辑器内集成了 Google 的 Agentic Data Cloud(一个整合了数据查询、管道调度等能力的云平台),你不需要切到别的控制台,就能查数据库、跑 Airflow 管道。
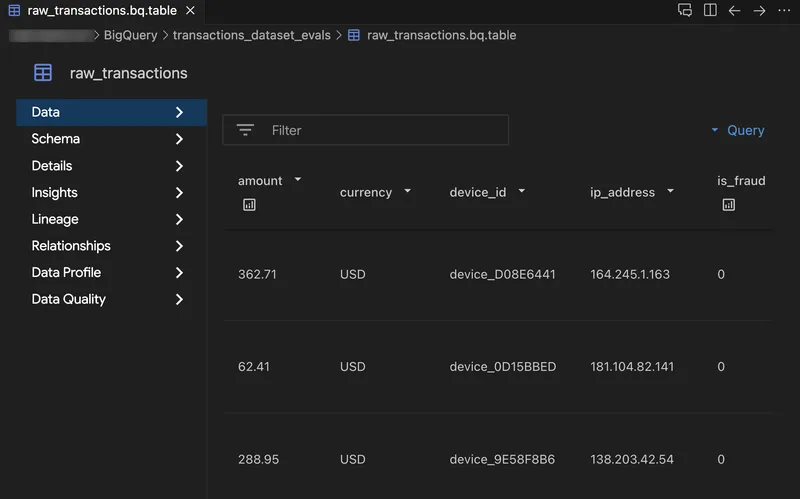
整个流程以一个具体场景展开。原始交易日志存在 Google Cloud Storage 里,你只需要对 Agent 说“建一个 notebook,把这些 JSON 日志加载进 BigQuery”,它就会生成一个 Jupyter notebook,里面用 Spark 读取 JSON 并写入 BigQuery 的 raw_transactions 表。你可以在 IDE 里打开 notebook 审阅代码,用预配置的 Spark Serverless 运行时(无服务器 Spark 执行环境,不用自己管理集群)一键运行。跑完后,Data Agent Kit 扩展允许你直接在 IDE 里浏览这张表、查看元数据,连表长什么样都看得见。
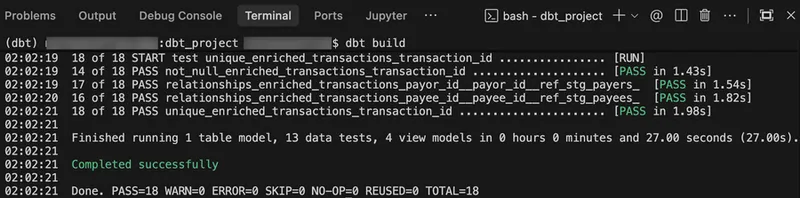
数据进 BigQuery 只是第一步,离训练模型还差得远。你还需要处理重复记录、缺失 ID,以及关联每笔交易的付款方和收款方信息。这些清洗逻辑不该一次性脚本了事,因为每天都有新数据进来。于是你让 Agent 生成一个 dbt 项目(dbt 是一个数据转换工具,用 SQL 定义表之间的转换逻辑,并且能自动跑测试),把清洗逻辑写成可重复执行的 SQL 模型。Agent 会生成一个包含多个 SQL 模型的 dbt 项目,处理重复行、关联参考表,并额外生成一张专门存放缺失交易 ID 记录的表。你在终端里跑 dbt build,它就在 BigQuery 里构建出 staging 表(中间层)和 enriched 表(增强后的数据表),同时执行唯一性测试——确保每条交易只出现一次。这里保留了 is_fraud 列,标记历史交易是否欺诈,后面模型就靠它学,再用学到的规律去打分未知的新交易。
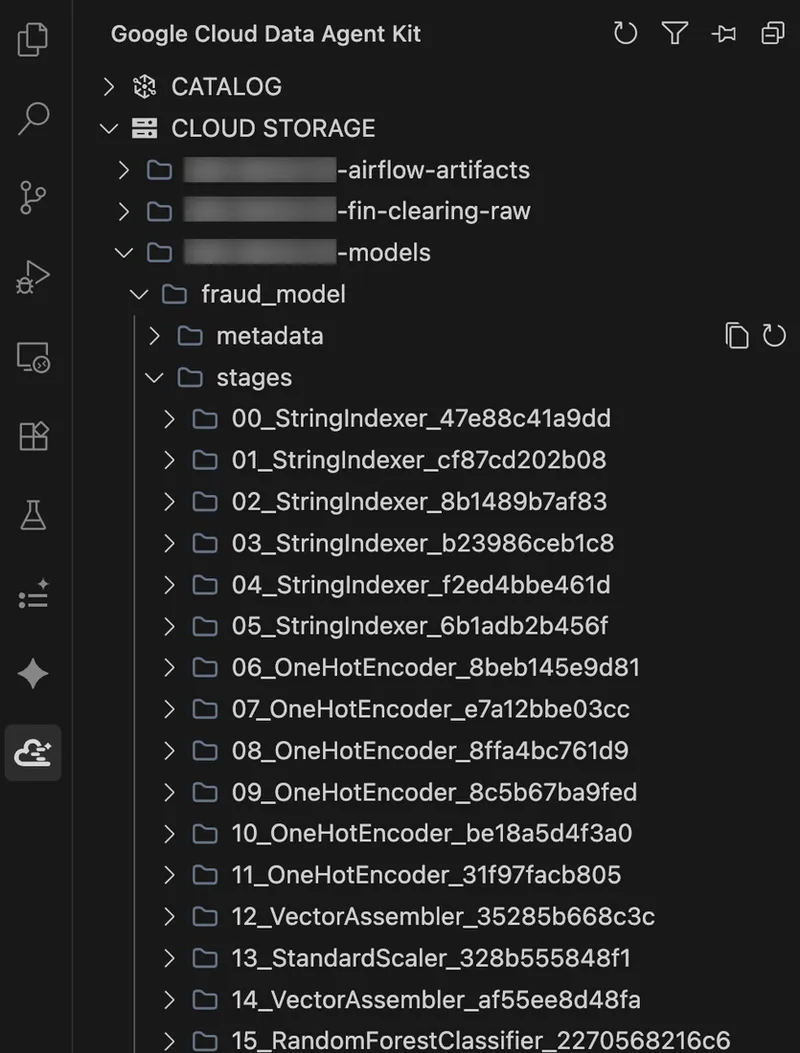
数据准备妥当,下一步是构建审查队列。让 Agent 创建一个训练 notebook,用 Random Forest 分类器(一种基于多棵决策树投票的机器学习算法)跑在 Spark Serverless 上。你审查并运行后,看它的评估输出,了解模型区分欺诈和合法交易的效果。Data Agent Kit 扩展还能帮你验证训练好的模型文件是否保存到了 Google Cloud Storage。保存好模型后,再写一个推理 notebook:对没有 is_fraud 标签的交易,用模型打出欺诈概率,把概率≥50%的记录写进 Spanner 的审查队列。Spanner 是 Google 的全球分布式数据库,这里用它存待审查的标记记录。你能直接在 IDE 里查询这个 Spanner 表,合规团队就从这个列表开始调查。
到这一步,你已经打通了从原始日志到审查队列的整条链路,但每一步都是手工触发的。接下来要做的是每天自动跑。用 Managed Service for Apache Airflow(托管的 Airflow 服务,Airflow 是一个开源的管道编排工具,能按依赖关系调度任务)把步骤串起来。让 Agent 生成一个 YAML 管道定义和部署配置:定义文件写明调度周期(每天)和步骤间的依赖关系,部署配置指定跑在哪个 Airflow 环境。Data Agent Kit 会把定义转成 Airflow DAG(有向无环图,表示任务执行顺序),你在 IDE 里能看到交互式流程图,点开任务还能直接跳回对应代码。配置好环境后,点画布上的“Run pipeline”,Kit 自动打包 notebooks 和 dbt 项目、部署 DAG、触发一次运行。你可以查看执行历史和每个任务的状态、时长、日志。之后 Airflow 每天定时跑,新批次数据自动从原始日志流向审查队列,合规团队只需专注被标记的交易,你也不用天天手动搬数据了。
这个思路的启发很直接:任何“每天重复的数据处理+模型打分+结果入库”的流程,都能用类似方式 Agent 化。关键在于把清洗步骤做成 dbt 模型,把训练和推理写成 notebook,再用 Airflow 编排——而 Data Agent Kit 的价值在于把这些步骤的脚手架自动生成,并且让你在 IDE 里一站式完成,不需要切换多个控制台。需要注意几个坑:生成代码必须人工审阅,尤其是数据清洗的边界条件和测试逻辑,不能无脑信任;模型训练和推理依赖的数据格式要稳定,否则每天跑容易出静默错误;Airflow 调度的失败重试和日志监控也别省,得留出处理管道异常的时间。如果你是做数据工程或 ML 平台的,这套“自然语言驱动 + 人工审查 + 自动调度”的模式值得参考,它把开发效率和数据生产化的成本都拉低了一截。
内容与图片版权归原作者所有 · 原文: https://cloud.google.com/blog/products/data-analytics/bringing-you-the-data-agent-kit/