 devgo.cn
核心观点
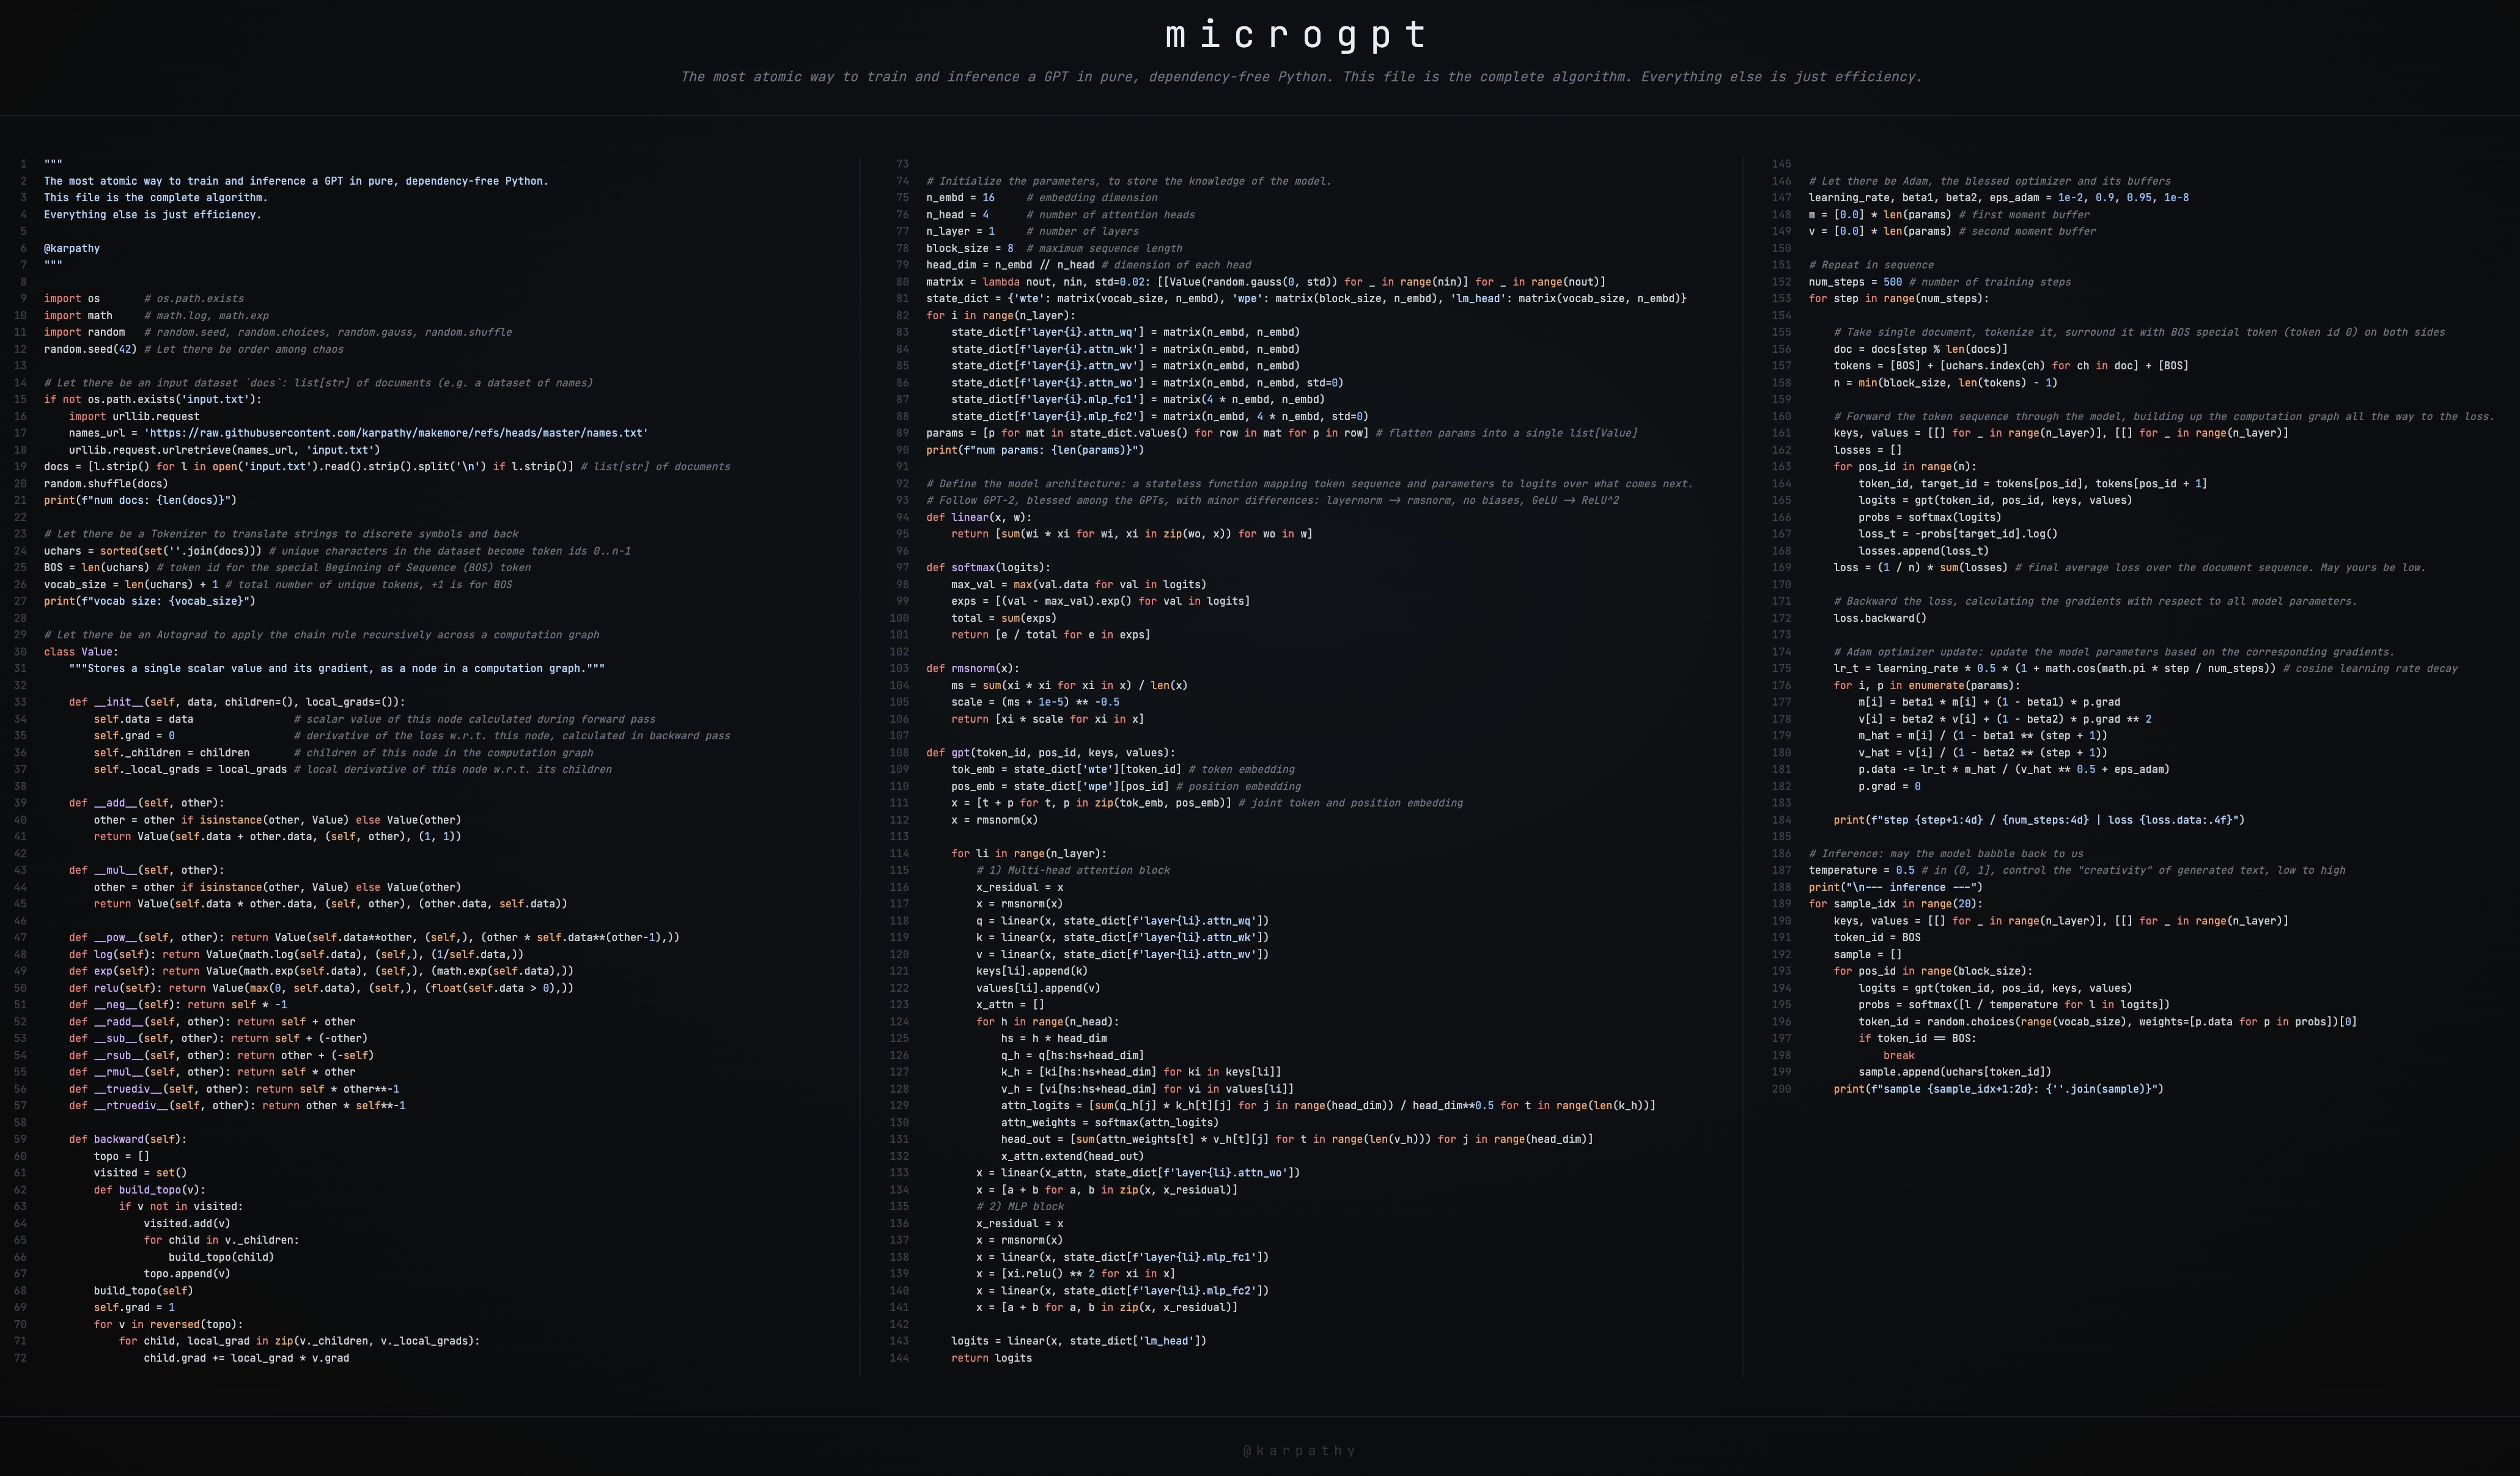
- microgpt 用 200 行无依赖纯 Python,完整覆盖 GPT 的训练与推理全流程:数据集、分词器、自动求导引擎、GPT-2 式网络、Adam 优化器、训练循环和推理循环。
- 设计哲学是「其余都是效率问题」:算法本质能压缩进一个文件,生产级系统只是在这个骨架上堆效率。
- 全流程以人名生成为例:32,000 个英文名字构成数据集,模型学会其中的统计规律后,能「幻觉」出风格相似的新名字。
- 代码以 GitHub gist、网页版和 Colab notebook 三种形式公开,本质上是 LLM 从零实现的标准教科书。
内容精讲
microgpt 是 Karpathy 多年「极简主义」系列的集大成之作——从 micrograd 到 makemore、nanoGPT,最终把大模型的算法内核压缩到单文件 200 行。文件里没有任何第三方依赖,把数据、分词、反向传播、网络结构、优化与推理全部串成一个可运行的闭环。理解它,就理解了大模型的骨架;生产系统里那些动辄百万行的框架,做的只是让骨架跑得更快、更大。
**数据是模型的燃料。** 生产环境中每篇文档对应一个网页,microgpt 则退回到最简单形态:一份包含约 32,000 个英文名的文本文件,每个名字当作一篇文档。脚本启动时若没有本地数据,就从 GitHub 自动拉取;随后随机打乱顺序,模型的目标就是学会这批名字的统计模式,并生成风格相似的新名字。这背后是 LLM 最核心的视角:你与 ChatGPT 的对话,从模型角度看也只是一篇「样子有点怪的文档」——你的提示词是文档开头,模型的回答是统计意义上的续写。
**分词器把文字变成编号。** 神经网络只认数字,所以需要把文本转为 token id。生产级分词器(如 GPT-4 用的 tiktoken)按字符块切分以提升效率,microgpt 用最朴素方案:给数据集里每个独特字符分配一个整数编号。26 个小写字母排好序后各得一个 id,再额外加一个特殊的 BOS(Beginning of Sequence)标记表示「一篇文档从这里开始/结束」。训练时每篇名字两端都包上 BOS,模型便学会 BOS 意味着新名字的开始。最终词表只有 27 个 token——这就是整个语言的「字母表」。
**自动求导是训练的引擎。** 训练神经网络需要梯度:对每个参数,要知道「把它调大一点,loss 是升还是降、变化多少」。计算图从众多输入(参数与输入 token)汇合到单一标量 loss,反向传播从 loss 出发按链式法则逐层回推。生产环境由 PyTorch 自动完成,microgpt 用 30 行代码的 Value 类从零实现:每个节点记录前向值、梯度、子节点和局部导数,重载加减乘、幂、log、exp、relu 等运算,自动构成计算图。
**网络结构即 GPT-2 的骨灰版。** 模型主体是与 GPT-2 同构的 Transformer:token embedding 把字符编号映射为向量,多个自注意力层捕捉上下文关系,positional embedding 注入位置信息,再经 Linear 层输出下一字符的概率分布。与生产模型相比,唯一差别是规模和层数——而「接下来是什么字符」的概率建模逻辑完全一致。
**优化与训练闭环。** 优化器选用 Adam,这是大模型训练事实上的标配;训练循环反复执行前向传播、计算交叉熵 loss、反向传播求梯度、按 Adam 规则更新参数。整个训练在 CPU 上即可快速完成——不需要 GPU,这也正是极简的魅力。推理循环则把学到的分布变成样本:从 BOS 开始,逐字符按概率采样并拼接,遇到 BOS 结束,一个名字就诞生了。文末展示的 20 个采样结果(kamon、karai、lerinne……)读起来已经「很像个名字」。
值得留意的是 microgpt 的审美:Karpathy 称之为「艺术项目」,代码刻意保持 3 栏排版、可打印成三联画售卖。这背后其实是一份教学主张——把黑盒彻底拆开,让每个人都能亲手摸到 Transformer 的每一个零件。
阅读价值
对初学者,这是一条从零理解 GPT 的最短路径:跟着 200 行代码,数据和 tokenizer 到反向传播、注意力再到采样,全部可视可运行。对从业者,它是剥离效率外衣后的算法骨架,能帮你重新校准对 LLM 本质的认识。
内容与图片版权归原作者所有 · 原文: http://karpathy.github.io/2026/02/12/microgpt/