 devgo.cn
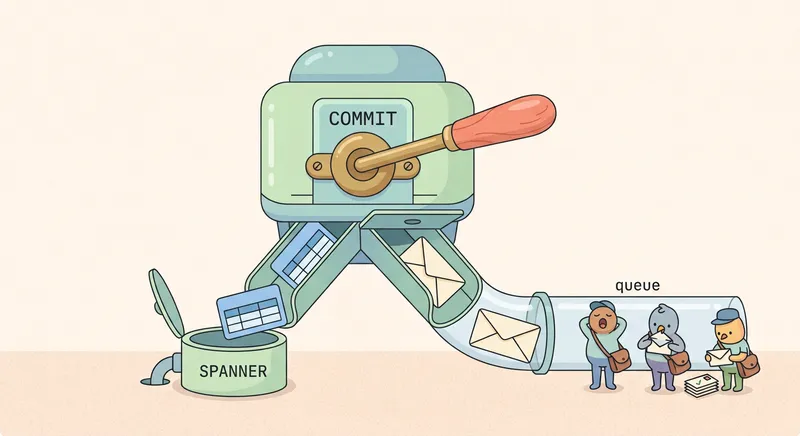
构建一个可靠的 AI Agent 系统,最头疼的往往不是模型本身,而是它背后的状态管理和异步任务调度。想象一下:你的 Agent 刚刚在数据库里把订单状态更新为“已退款”,紧接着要往消息队列里发一条“执行退款”的任务。如果数据库提交成功了,但消息发送失败,Agent 就“决定”了退款却没“执行”;反过来,如果消息发出去了但数据库事务回滚,Agent 就会基于一个无效的状态去执行操作。这种“决策”和“执行”之间的割裂,在多 Agent 协作、重试、竞态条件下会被无限放大,逼着开发者去实现复杂的 outbox 模式(一种在数据库事务里先写消息表、再异步投递的补偿方案)、幂等层和对账 Worker。Google 这次发布的 Spanner queues,就是想把这个问题从根上解决掉——它把消息队列直接内嵌进 Spanner 数据库,让“改状态”和“发消息”变成同一个事务里的两次普通写入,要么一起成功,要么一起失败。
这个思路最直接的价值,是让 Agent 的“决策-执行”链路变得原子化。在 Spanner queues 里,创建一条消息就是事务里的一个写操作。Agent 在同一个读写事务里,既能更新自己的记忆表或状态表,又能同时把任务入队给其他 Agent。因为 Spanner 本身提供严格串行化和全局外部一致性,状态变更和执行意图就作为一个原子单元提交了。这意味着你不再需要担心“状态改了但任务没发出去”或者“任务发出去了但状态没改”这种幽灵问题。对于 Agent 这种需要自主执行多步操作的工作负载,这等于把可靠性税直接从架构里抹掉了。
除了原子入队,Spanner queues 还针对 Agent 的典型工作模式做了几个很实在的设计。第一个是定时调度,消息可以立即投递,也可以指定在未来某个时间点才可见。这正好覆盖了 Agent 的延迟重试、定时检查、SLA 升级计时器这些场景,而且这些定时任务可以和记忆更新放在同一个事务里提交,不需要再引入外部的 cron 调度器或轮询基础设施。第二个是流式 SQL 拉取,Agent Worker 可以用流式 SQL 查询来动态消费任务,处理完在事务里确认完成,保证端到端的任务执行状态可靠。第三个是记忆持久化,Agent 的长期情景记忆摘要、反思状态转换、子 Agent 之间的上下文交接,都可以通过队列异步且事务化地持久化,既保证记忆和执行历史完全同步,又不阻塞实时交互。
Spanner queues 对多 Agent 编排的支持也很有意思。在 A2A(Agent-to-Agent)架构里,主 Agent 把状态交接给专家 Agent,这个交接动作本身就是一个持久化、事务性提交的消息。专家 Agent 的 Worker 接收消息,同时整个交互过程都有可审计的完整血缘。更实用的是它对超时和人工介入流程的原生支持:一个事务里同时记录“等待审批”的状态和“自动升级”的定时消息,哪个先触发就处理哪个,彻底告别了手动管理超时计时器的痛苦。而且,所有队列都是 Spanner 里的普通关系表,你可以直接用标准 SQL 查询在途任务、监控积压、审计执行历史,不用再面对消息存储这个黑盒。
底层机制上,Spanner queues 把队列实现为一等公民的关系结构,用 GoogleSQL 就能定义、查看和管理。核心操作包括:在事务里原子地更新订单状态并插入任务消息;通过设置 DeliverTime 列实现定时可见性,如果经理提前审批了,就在同一个事务里用 SQL DELETE 取消那个待升级的任务,不会出现几天后幽灵告警;Worker 用 RECEIVE_<QueueName> 表值函数通过流式 SQL 连接消费任务,Spanner 自动管理消息租约,返回唯一的租约令牌和过期时间戳。考虑到 AI Agent 任务经常涉及多轮 LLM 推理或外部 API 调用,耗时可能超过默认租约窗口,Worker 可以主动用 RENEWLEASE_<QueueName> 函数续租。任务完成后,Worker 开启读写事务记录最终状态,并用带 ASSERT_ROWS_MODIFIED 1 的 DELETE 来确认消息。这个断言很关键:如果 Worker 因为网络卡顿导致租约过期,另一个 Worker 可能已经处理并删除了任务,当卡顿的 Worker 恢复后尝试执行删除时,ASSERT_ROWS_MODIFIED 1 会发现行已经不存在并抛出语句级错误,捕获这个错误并中止事务,就能防止旧 Worker 覆盖新状态。
Spanner queues 的适用场景远不止 AI Agent。任何需要可靠异步消息传递的传统事件驱动架构都能受益:社交应用里的实时动态流、新闻发布里的实时更新、零售里的订单处理和库存编排、金融里的高吞吐异步任务处理和交易通知。它本质上是在你的主数据库里提供了一个事务性事件驱动的工作流基础。不过要注意,它和 Spanner change streams(变更数据流,用于捕获数据库的插入、更新、删除操作并近实时地推送给下游做集成和审计)定位不同:change streams 面向持续的数据变更捕获和流式分析,而 Spanner queues 面向事务性任务编排,原生支持消息租约、定时投递、SQL 拉取。如果你正在构建 Agent 系统,并且被“数据库和消息队列状态不一致”折磨过,这个把队列融进事务的思路值得直接借鉴——它把可靠性问题从应用层下沉到了基础设施层,让开发者能专注于业务逻辑本身。
内容与图片版权归原作者所有 · 原文: https://cloud.google.com/blog/products/databases/spanner-queues-provide-native-transactional-messaging/