 devgo.cn
你有没有遇到过这种场景:数据库要升级,老板问你“会不会出问题”,你说“我们跑了 sysbench 压力测试,看起来没事”,但上线后还是出了兼容性 bug,某个查询在新版本上返回了不一样的结果。问题就在于,合成基准测试(比如 sysbench 这类用固定脚本模拟负载的工具)根本覆盖不了生产环境里那些千奇百怪的查询——用户真实请求的 SQL 组合、执行顺序、事务上下文,远比几个标准模板复杂。Airbnb 也踩过类似的坑,他们的做法是把生产数据库的真实流量完整捕获下来,再离线回放到目标库上做压测、容量规划、升级验证。这套系统已经支撑了他们数百个 MySQL 兼容集群、每秒数百万次查询的规模,值得拆开看看。
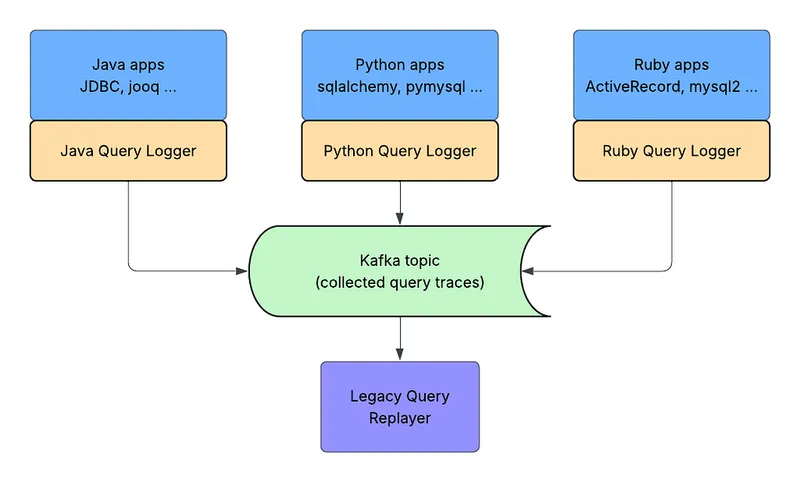
先说他们之前的痛点。Airbnb 最早是从可观测性管线里“借”了一套方案:每个语言绑定的客户端各自记录查询日志,发到 Kafka(一种分布式消息流平台,用来在系统间传递数据),然后按用例处理,再用自研回放器跑一遍。这套东西毛病不少:一是每个语言都得改自己的日志框架,维护成本高,所有权模糊;二是在他们强调微服务拆分(SOA,把系统拆成多个独立部署的小服务)的架构下扩展性很差;三是最关键的一点,捕获的数据缺乏完整的事务上下文,没法把“同一组查询在旧库和新库上是否返回一样结果”这件事验证清楚。
于是他们定了三个目标:用真实流量做压测,解决集群容量该扩还是该缩的问题;通过回放同一份流量到两个目标库并对比结果,提前暴露升级或迁移时的兼容性差异;以及在事故排查时能离线重现问题现场。要达成这些目标,需要一个不依赖客户端语言、也不改应用的统一捕获点。他们选择了 ProxySQL——一个开源代理,懂 MySQL 的线协议,本来就部署在应用和数据库之间,所有流量已经经过它,自然成了捕获的最佳位置。
整个系统由三个组件构成,全部自研:Log Mover(日志搬运器)、Log Processor(日志处理器)、Log Replayer(日志回放器)。因为捕获的查询可能含个人数据,这套管线对流量按生产数据同等对待:传输和存储都加密,访问遵循最小权限原则,只开放给数据库基础设施团队,日志只在测试窗口期对集群开启,回放只跑在与生产等价的环境里,绝不把流量打到低环境或复制到开发层。
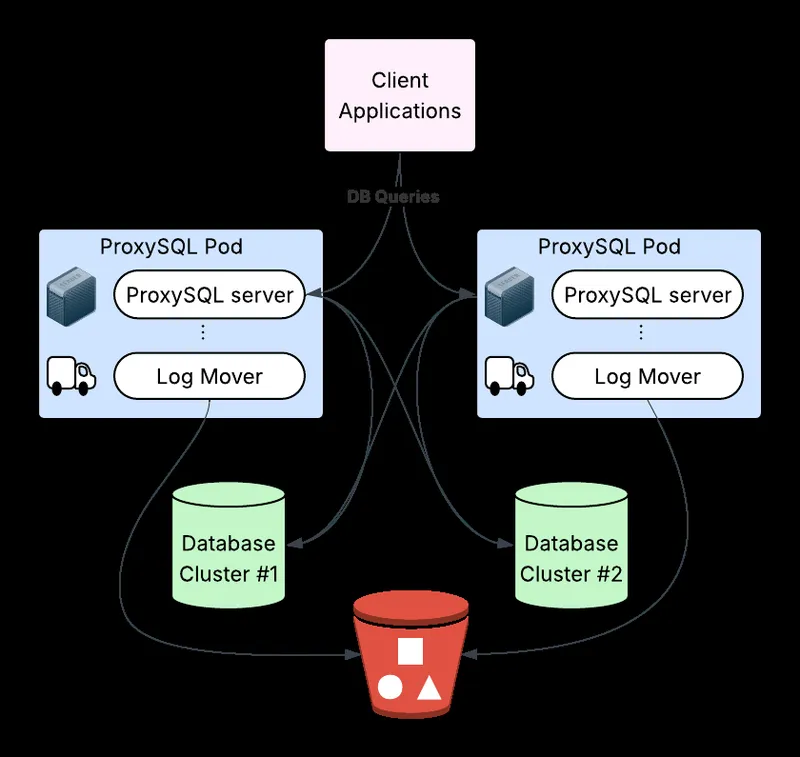
先看 Log Mover。ProxySQL 自带查询日志功能,通过查询规则控制开关,可以只针对某一集群开启,不影响其他流量,开启后把日志写到本地磁盘,对查询性能影响很小。Log Mover 作为 ProxySQL 部署的 sidecar(放在同一 Pod 里的辅助容器,负责日志收集),监控这些日志文件,持续传送到云对象存储,避免本地磁盘被撑满。
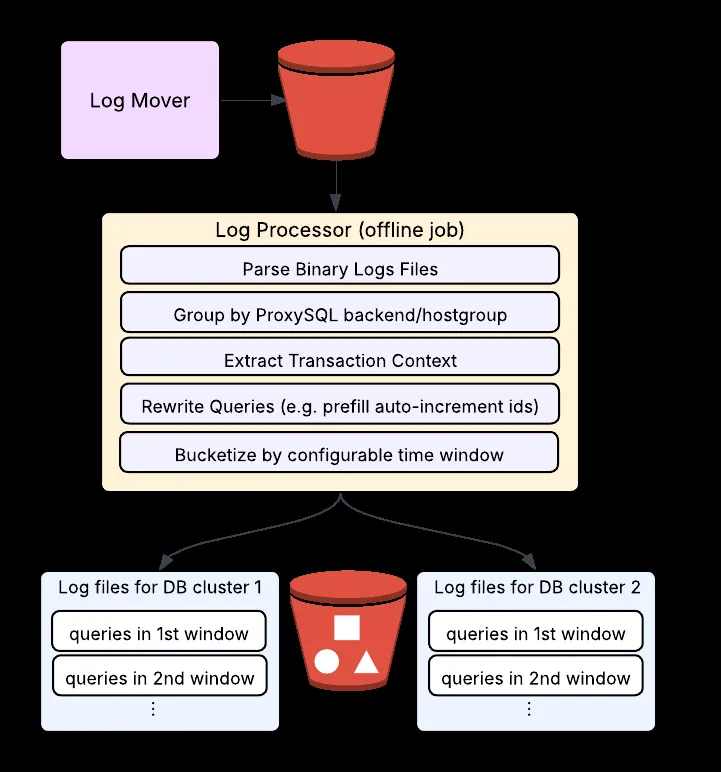
接下来 Log Processor 是离线任务。Airbnb 的 ProxySQL 跑在 Kubernetes(容器编排平台,管理一组可伸缩的 Pod)上,是一组无状态 Pod 的池子,每个 Pod 同时服务多个后端集群,所以单个日志文件里混着来自多个数据库集群的查询。Log Processor 要把原始二进制日志按集群拆分成独立文件,再把并发连接交错的语句按原事务顺序重新组装,这样回放时才不会改变行为。处理后的文件按查询时间戳分桶,每桶是五分钟窗口内、某个数据库集群加某个 ProxySQL Pod 的查询,这样回放器就能精确控制回放速度、吞吐量、整体负载。此外还存下元数据,比如时间戳、用户名、集群名、schema 名,方便按条件定位某个时间段的日志。
这里一个有意思的设计是查询改写。MySQL 默认的自增值是单调递增的,但 MySQL 8.0 允许自定义自增方式以提升性能,某些兼容 MySQL 的数据库分配自增值的方式也可能不同,这会导致一个 INSERT 语句产生的 last_insert_id 与生产环境不一致。后续依赖这个值的读操作(比如查刚插入的那一行)就会失败或返回空,污染测试结果。Log Processor 会把每条 INSERT 语句改写成显式带上捕获到的 last_insert_id:原本 `INSERT INTO users (name) VALUES ('bob')` 如果产生 id=1,就被改写成 `INSERT INTO users (id, name) VALUES (1, 'bob')`。这个写法的代价是回放时不再测试目标库原生自增逻辑,但换来了跨库行为一致性,减少兼容性测试中的假阳性。
回放端 Log Replayer 有三个部分:API Server(控制面,提供 Web UI 让用户提交和管控回放任务)、Replay Task Scheduler(任务调度器)、Replay Task Workers(一群执行回放的工作节点)。用户通过 Web UI 设置参数:源集群(要回放哪个集群的流量)、时间范围、目标数据库端点、回放模式(两种模式下面说)。
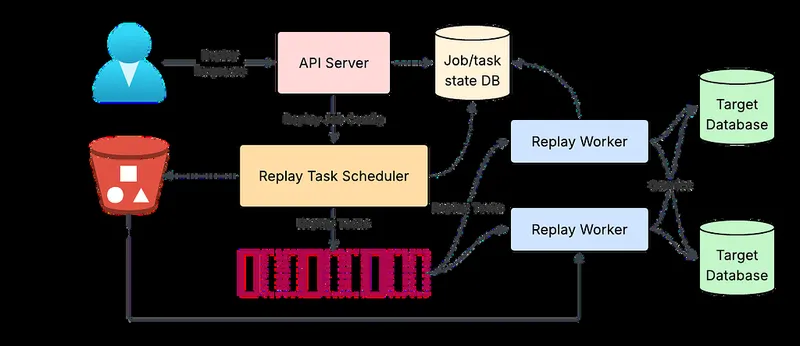
回放模式有两种,一种是按原始速率回放,适合验证升级兼容性;另一种是放大速率,比如以多倍于生产的吞吐量回放,用来模拟未来增长、评估容量。回放时持续比较源库和目标库的响应结果,出现不一致就标记出来。这套系统最后能给他们带来三方面直接收益:容量规划上,用真实流量按不同倍数回放,能发现哪些集群余量不足要扩容、哪些过度预留可以缩容;升级迁移前,对两个目标同时回放同一份流量,提前暴露行为差异,避免上了生产才发现不兼容;性能排查上,完整 SQL 加事务上下文让工程师能离线重现问题现场,验证修复是否有效再发布。
最让我意外的是他们在捕获点上的取舍——没有选择侵入应用去埋点,而是利用已有的代理层,几乎零成本地拿到了全量流量。这个思路在很多场景都能借鉴:如果你也有一个中心化网关或者代理,不管是数据库、消息队列还是 HTTP 网关,都可以用它做流量录制回放,而不需要每个服务自己去实现。要注意的坑有两个:一是流量数据是敏感数据,必须像生产数据一样严格管控,Airbnb 甚至规定回放绝不能打到低环境,这是合规底线;二是自增值改写这类“保一致”的操作会牺牲一部分原生行为观测,你得想清楚自己的测试目标更在乎哪个方面。另外,回放结果里假阳性往往来自时序、并发、事务隔离级别这些差异,所以尽量按原始日志里的交叠顺序回放,而不是简单串行重放。这套系统的做法,放到你自己的压测、迁移、故障复盘里,完全可以落地成一套“录真流量、回放验证”的标准化流程。
内容与图片版权归原作者所有 · 原文: https://medium.com/airbnb-engineering/beyond-synthetic-testing-capturing-and-replaying-real-database-workloads-at-airbnb-cea7ee9b1ab2?source=rss----53c7c27702d5---4