 devgo.cn
结论先说
Meta 公布了新一代 Andromeda——广告推荐链路里负责**召回**的那一层。它在生产环境里对每一条候选广告都用接近排序阶段的模型精度打分,单卡吞吐做到**每秒十亿条以上**,官方称这是召回阶段模型的新基准,比 2024 年的 Andromeda **提升约 100 倍**;单张 GH200 上模型推理峰值超过每秒 100 亿条。业务侧自 2025 年起在 Facebook 带来 **2.4% 的转化提升**。
更值得工程团队看的不是这些数字,而是他们给出的方法:模型、系统、硬件三件事一起设计,而不是各优化各的。
为什么召回突然成了瓶颈
召回要在毫秒内把海量候选缩到一小撮,再交给更贵的排序阶段精算。长期以来的共识是:排序级的模型精度太贵,召回用不起。
2024 年那版 Andromeda 把模型容量提升了四个数量级,此后生成式素材工具让广告主几天就能产出上亿条新广告,候选池膨胀到前所未有的规模。想在这个池子上用更好的模型、还要更高的吞吐,就必须同时在三个方向突破:
- **模型**:需要新的架构,把性能往上推而不让成本同比例上涨。
- **系统**:吞吐到十亿级之后,瓶颈从算力变成**内存带宽**——GPU kernel 之间的中间张量每秒要走 TB 级流量;在本机 CPU 和远端加速卡之间搬运广告,会把网络链路打满。
- **硬件**:得知道离硬件天花板还有多远,才知道模型还能长多大。
架构上的三处改动
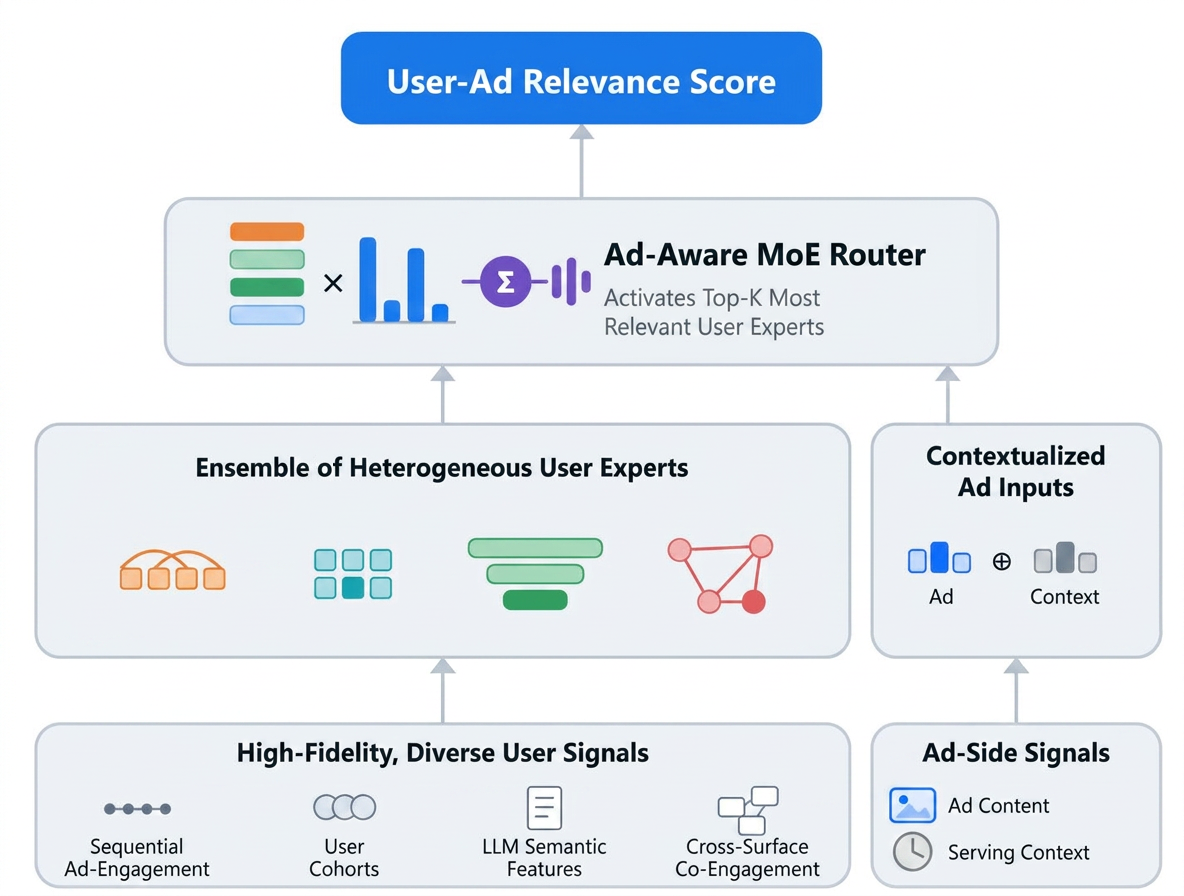
他们把 LLM 里的 MoE 思路搬进了召回,具体是三层:
- **用户侧**:从单一 user tower 改成一组专精的 user tower 当专家,吃进序列化的广告交互、人群表征、LLM 抽的语义特征、跨场景共互动信号。
- **广告侧**:候选塔做联合编码,把实时服务上下文编进去,让下游交互模型拿到带上下文的表示。
- **交互层**:从稠密网络换成带注意力门控的 MoE,按候选动态路由到最相关的用户专家。
结果是模型精度逼近排序级,而推理 FLOPs 比 2024 年的召回模型**少约 300 倍**。
系统侧:一个 kernel 干掉中间流量,一个盒子干掉网络
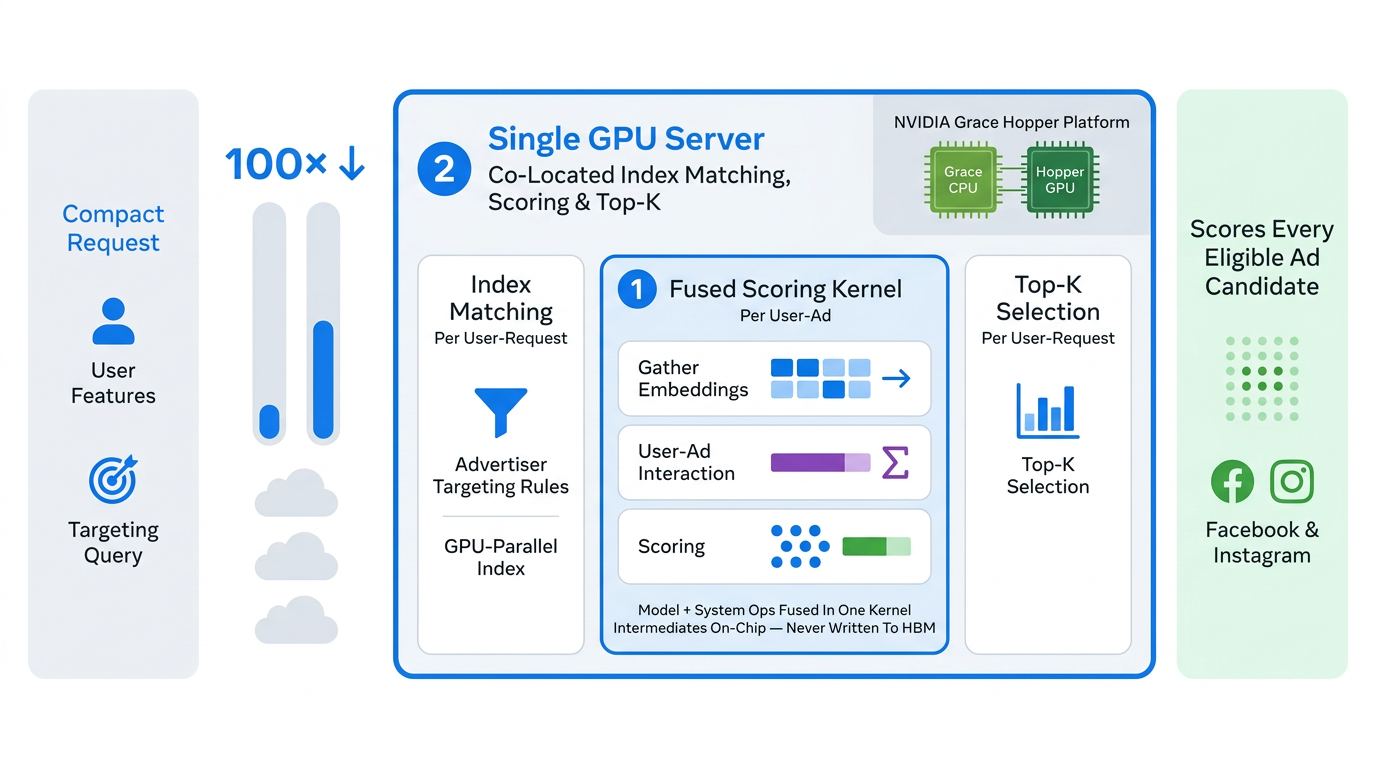
- **融合 kernel**:把模型执行和系统逻辑(取 embedding、算交互、打分)压进单个 kernel,一条龙跑完。中间结果留在寄存器和共享内存里,不回写 HBM——召回本质是带宽受限,省掉的就是这层冗余流量。
- **同机部署**:把索引匹配(广告主定向规则)、打分、top-K 选择全部搬到同一张 GPU 上。过去是把大候选列表跨主机搬运,现在只发一份很小的请求(用户特征 + 定向查询),服务器本地跑完整条链路,只回 top-K,**网络流量下降约 100 倍**,系统重新变回 GPU 计算受限。
- 难点在于索引匹配要支持几十类特征的复杂定向逻辑,还要在一天里随广告新建、修改、过期实时更新。这需要为 GPU 并行重做索引结构,同时保住生产语义的完整性。
和 NVIDIA 一起把每个部件顶到硬件边上
2026 年初两家开始联合调优,各部件拿到 2 到 5 倍加速:
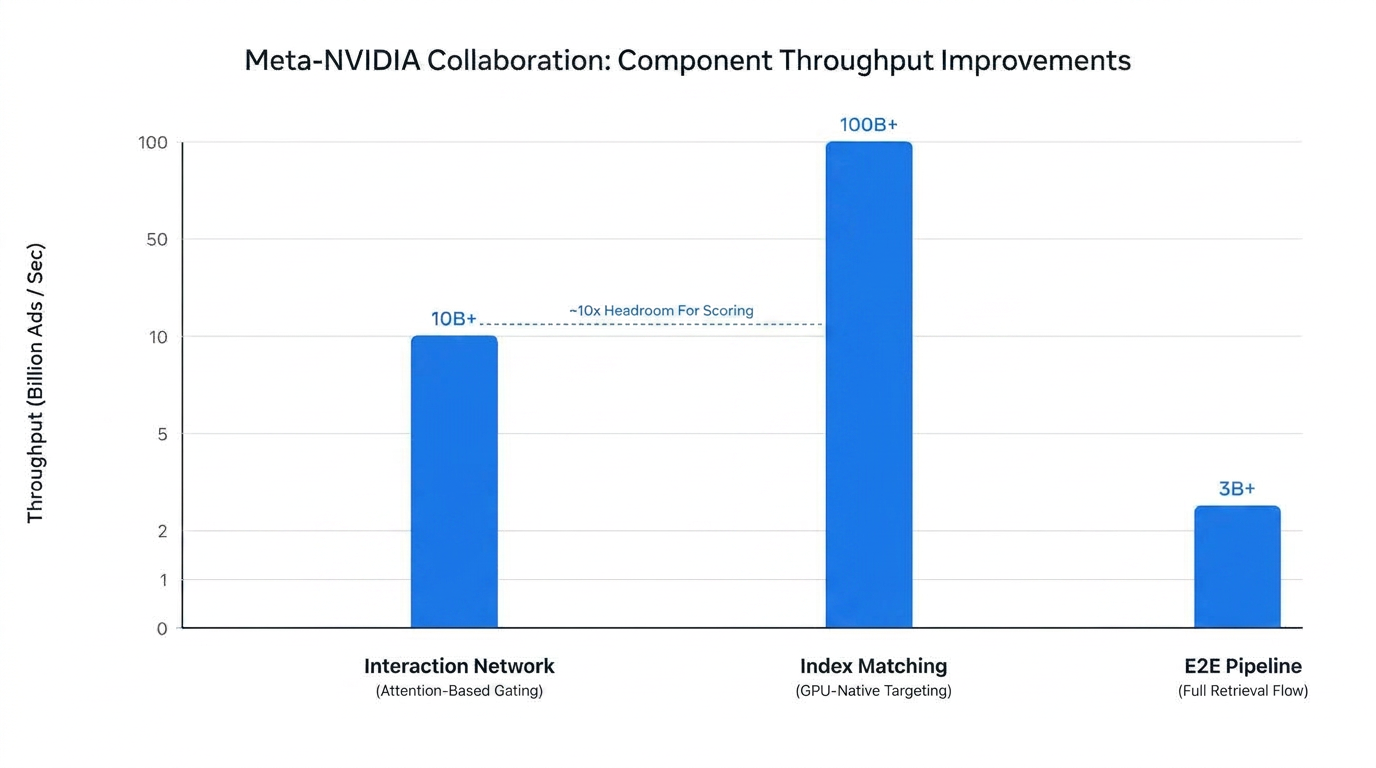
- **门控 kernel 提速 5.3 倍**:从每秒 24 亿条到 100 亿条,达到 GPU 峰值 HBM 带宽的约 85%。这个吞吐下,门控的执行时间和一个简单的点积打分 kernel 相当——也就是说,多出来的模型表达能力在 Tensor Core 上几乎是免费的。
- **INT8 量化**再带来最多 2 倍提升,精度与 16 位持平。
- **索引匹配提速 2 倍以上**,达到每秒 1000 亿条,比打分网络高一个数量级,因此可以放心地在多条召回通路里重复跑而不成为瓶颈。
- **端到端**:剖析发现延迟里很大一块来自部件之间的数据搬运,而不是计算;统一数据布局、去掉多余间接层之后,单机吞吐是当前生产值的数倍。
可以带走的三条
1. **瓶颈会转移,别按旧瓶颈设计**:算力够了以后,先卡中间张量带宽,再卡跨机网络,最后卡索引结构的并行度。
2. **性能优化要给模型留余量**:FLOPs 降 300 倍不是为了省钱,是为了让「更复杂的模型」在同一条延迟预算里放得下。
3. **别只调 kernel**:他们下一步在 Grace Blackwell 上研究 CPU 与 GPU 的算力配比,因为这类负载对配比很敏感——单点最优不等于系统最优。
内容与图片版权归原作者所有 · 原文: https://engineering.fb.com/2026/10/28/ml-applications/meta-andromeda-next-gen-ads-retrieval-gpu-co-design/