 devgo.cn
你有没有遇到过这种场景:服务刚启动那几秒 CPU 飙到 100%,但等真正跑起来后 CPU 利用率却低得可怜。为了保证用户请求不被卡住,你只能把 CPU request 调大,结果一整天的账单里有一大半是给闲置资源付费。这是 Kubernetes 世界里一个长期存在的两难问题:启动时需要大量 CPU 做初始化,稳定后又用不了那么多。Google 最近给 GKE 带来了一个叫 CPU startup boost 的预览功能,直接内置在 Vertical Pod Autoscaler(VPA,即根据实际负载自动调整 Pod 资源请求的组件)里,能在容器启动时临时提高 CPU 分配,等应用就绪后自动降回基线,全程不重启容器。
为什么现代应用启动时要吃这么多 CPU?
一个容器从创建到真正开始服务用户,中间要做很多“热身”工作。拿 Java 举例,Spring Boot 这类框架启动时要加载类、扫描 classpath、实例化依赖注入容器,还要跑 JIT 编译(即把热点代码编译成机器码的机制)。Node.js 应用要解析 JavaScript 文件、构建模块依赖树、执行 V8 引擎的优化和 JIT 编译。Python 的 AI/ML 微服务更不用提,导入 PyTorch、NumPy、LangChain 这些重型库就要花掉不少 CPU 周期,还要编译 .pyc 字节码、建立 ORM 数据库 schema、预加载缓存。这些初始化工作如果 CPU 不够,就会被强行限流(throttling),导致冷启动变慢、readiness probe(就绪探针,用来判断应用是否准备好接收流量)超时。
于是大家通常的做法是:把 CPU request 按启动峰值来配。但问题是,应用一旦稳定下来,这些额外预留的 CPU 就完全闲置了。用启动峰值来恒定配资源,等于每天给“闲置的启动余量”付钱。
CPU startup boost 的解决思路很直接:让 Pod 在启动阶段临时拿到更高的 CPU 配额,等初始化完成后再自动降回稳态基线。这个功能集成在 GKE 的 VPA 里,能实现“热调整”——不重启容器,就在运行中动态修改资源请求。
底层机制:Kubernetes In-place Pod Resize
以前要改 Pod 的 CPU request,唯一的办法是删除 Pod 重新创建,这一折腾就要重启容器、清缓存、重新调度,代价很大。CPU startup boost 基于 Kubernetes 的 In-place Pod Resize(IPPR,即动态原地修改 Pod 资源请求而不重启的特性)实现。IPPR 从 KEP-1287 发展而来,在 Kubernetes 1.27 进入 Alpha,1.33 升 Beta,1.35 正式 GA。它让控制面和 kubelet 能直接更新运行中容器的 CPU 和内存请求,容器进程不用重启。GKE 在 VPA 里利用 IPPR,在 Pod 调度时施加启动 CPU 提升,等就绪后平滑降回。
具体工作流程分三个阶段:
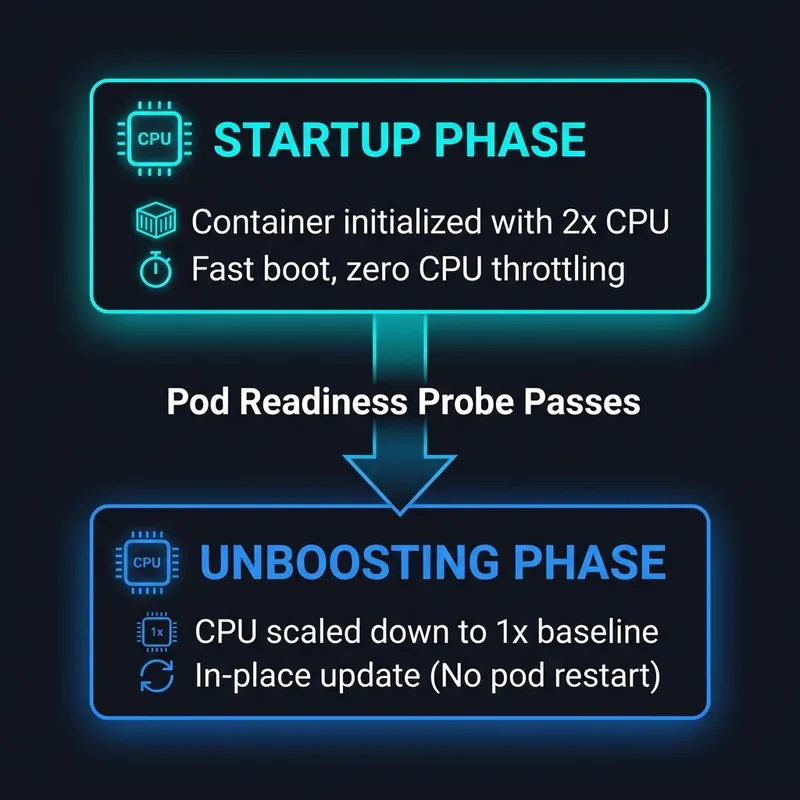
**Admission 阶段**:你部署 Pod 时,VPA 的 admission webhook 拦截创建请求,根据你配置的策略(比如 CPU 翻倍,或固定加 2 个 vCPU)算出提升后的 CPU 请求,连同跟踪注解一起注入到 Pod spec。
**Startup 阶段**:Pod 调度起来后,带着提升后的 CPU 配额做初始化,类加载、JIT 编译、模块解析都跑得飞快,不会触发 CPU 限流。
**Unboosting 阶段**:一旦 Pod 的 readinessProbe 通过(再叠加你配置的 durationSeconds 冷却时间),VPA updater 就发起一个原地调整请求,把 CPU 请求降回基线,容器全程不中断。
配置方式也相当简单——在 VerticalPodAutoscaler 的 manifest 里加一段 startupBoost 配置就行。官方给了三种示例:
- 只用启动提升、稳态 CPU 保持不变:把 updateMode 设为 "Off",GKE 会在启动时把 CPU 翻倍,就绪后等 10 秒再降回基线。
- 启动提升 + 持续自动扩缩:把 updateMode 设为 "InPlaceOrRecreate",启动阶段提升,启动后继续用 VPA 优化稳态资源。
- 细粒度针对容器:如果 Pod 里有 sidecar(比如日志代理或 service mesh 代理,不需要启动 CPU 提升),可以只针对特定应用容器设置提升。
验证是否生效可以用 kubectl 看 Pod 注解里的 vpaCpuStartupBoost 标记,以及检查事件里有没有 reason=InPlaceResizedByVPA 的条项,确认就绪后成功降回基线。
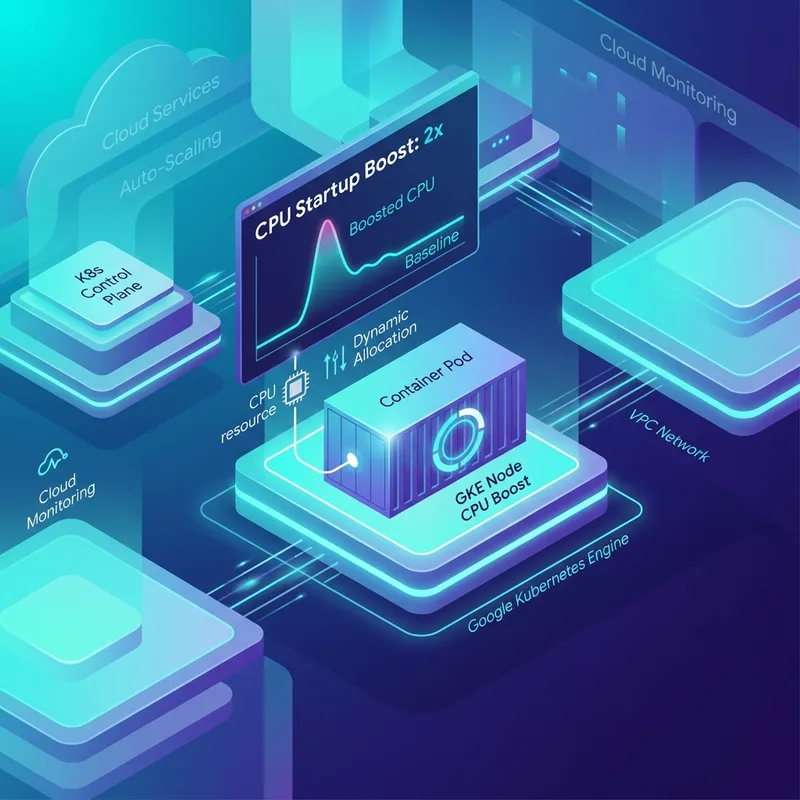
这里展示了 IPPR 如何实现动态调整资源请求的示意图,可以直观看到 Pod 在运行中的 CPU 变化曲线。
官方还给出了几条生产环境最佳实践:如果你同时用了 HPA(Horizontal Pod Autoscaler,横向自动扩缩组件),一定要定义好 readinessProbe,并让 durationSeconds 尽量短(0-10 秒),防止 HPA 把启动期的 CPU 尖峰误判成持续高负载而错误扩容。另外可以搭配 GKE capacity buffers API 来吸收突发流量,因为启动开销变小了,同样的节点能承载更多工作负载。在 GKE Autopilot 模式下要注意 CPU 与内存的比例关系,要确保基线内存能容纳启动期间的 CPU 提升比例。
最让我意外的是这个功能对冷启动的加速效果:官方称可以减少最多 2 倍的初始化时间,而且完全靠自动调节,不用手动改任何 Pod 规格。这种“临时借力、用后即还”的思路其实可以推广到很多资源管理场景——凡是存在“启动峰值远大于稳态需求”的工作负载,都值得借鉴。比如批量任务、模型加载、缓存预热,甚至 CI/CD 的构建容器,都能用类似的机制来避免过度配置。
当然,这还只是 preview 功能,需要 GKE 1.36.0-gke.4447000 或更高版本,且 Standard 集群必须启用 VPA,Autopilot 则默认开启。目前支持 Deployment 和 StatefulSet 这类标准控制器。
配置示例的截图,可以看到在 VPA manifest 里添加 startupBoost 的具体写法,直观又简单。
如果你的应用正好卡在“启动慢”和“资源浪费”之间,不妨试试这个功能。不过记得先在生产环境做灰度:确认 readinessProbe 的配置正确,否则一旦启动阶段就被判定就绪,CPU 太早降下来可能反而拖慢启动。另外,如果你用的是自定义调度器或者复杂的多容器 Pod,务必验证容器级策略是否按预期工作。总的来说,这个功能的落地意味着 K8s 资源管理的精细度又上了一层——不再被迫二选一,而是可以“按需借力”。
内容与图片版权归原作者所有 · 原文: https://cloud.google.com/blog/products/containers-kubernetes/gke-cpu-startup-boost-faster-pod-starts-lower-costs/