 devgo.cn
想象一下,你正在做一个在线协同编辑工具,几十个用户同时改同一份文档,每个用户的 WebSocket 连接都实时推送他人改动。突然,AWS 某个区域(Region,也就是云服务商部署数据中心的地理分区)宕机,所有连接瞬间断开,等机房恢复后用户重新连上,却发现文档状态回滚到了几分钟前——因为会话上下文(比如未保存的编辑记录、光标位置、临时状态)存在服务器内存里,随着连接一起没了。这正是 WebSocket 应用在区域级故障时最棘手的问题:连接是持久的,但它和状态是绑定的,故障一来,两者一起消失。
这篇来自 AWS 官方博客的文章给了一套完整的多区域容灾设计模式,核心思路一句话:把应用状态从连接中剥离出来,存到跨区域复制的数据库里。这样客户端重新连上时,无论连到哪个区域,都能从共享状态中恢复自己的会话,就像什么都没发生过。
整个架构是典型的 active-passive 双区域部署:主区域负责正常流量,备区域时刻待命。两个区域部署完全一样的 API Gateway WebSocket API 栈(API Gateway 是 AWS 托管 WebSocket 接入服务,负责处理连接生命周期和消息路由),底层用 DynamoDB Global Tables(Amazon 的托管 NoSQL 数据库,支持跨区域自动异步复制,通常延迟在一秒以内)把应用状态同步到备区域。前端统一用一个自定义域名,通过 Amazon Route 53(AWS 的 DNS 服务)的故障转移路由策略,平时解析到主区域,一旦主区域不健康,DNS 自动切到备区域。客户端只需重连同一个域名,不需要改任何配置。
故障检测是这套方案里容易被忽略但极关键的一环。他们没有依赖外部健康检查,而是部署了一个独立的 `canary`(金丝雀探测,就是一个定期跑的健康巡检任务)——一个 EventBridge(AWS 的事件调度服务)规则每分钟触发一次 Lambda 函数,主动向 API Gateway 打开一条 WebSocket 连接,发一条心跳消息,再把结果写入 CloudWatch(AWS 的监控服务)自定义指标。如果连续失败或指标停止更新,CloudWatch 告警会触发关联的 Route 53 健康检查,标记主区域不健康,DNS 随即切到备区域。这种“流量无关”的探测方式很聪明:即便没有真实用户访问,也能提前发现区域故障,而不是等用户抱怨了才被动响应。
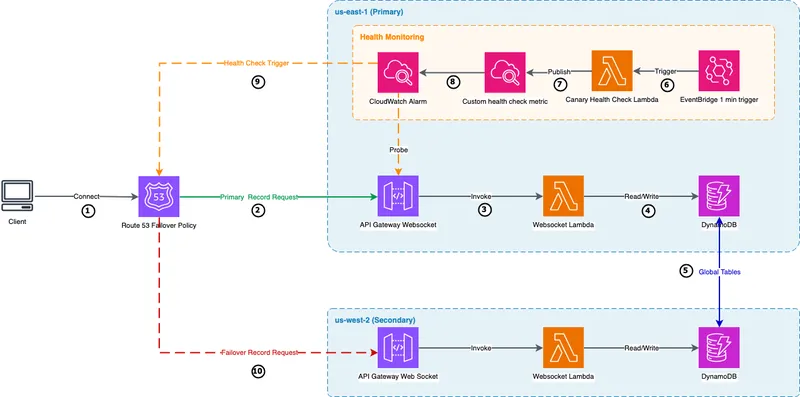
展示了整套架构和正常/故障转移流程。
原文章配了一个非常直观的演示应用:一个实时拍卖系统,多个用户同时对同一件商品出价,每次出价都通过 WebSocket 广播,所有在线客户端实时看到最新价格。界面还会显示当前服务来自哪个区域,方便你亲眼验证故障转移。虽然这是最小化示例,但它代表了所有共享可变状态的实时工作负载——聊天、协同编辑、直播榜单、多人游戏。
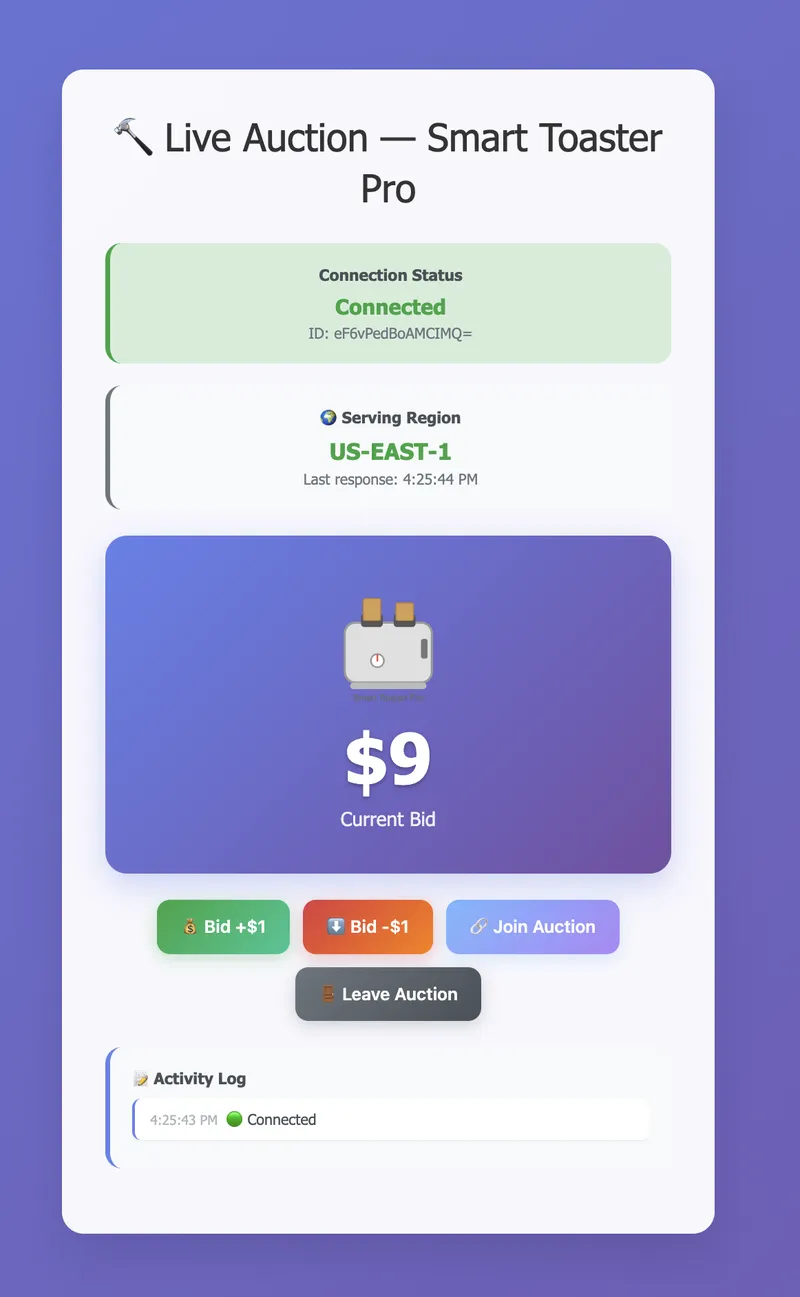
是演示应用的界面。
真正值得深挖的是连接状态怎么恢复。WebSocket 连接是持久的,但服务器端会为每个用户维护会话数据。故障转移后客户端重连到备区域,怎么找回自己的状态?文章给出的方案是:状态按用户 ID 存储,而不是按连接 ID 存储(连接 ID 每次重连都会变)。客户端重连后主动发一条 `getState` 消息,从备区域的 DynamoDB 副本里拉取最新状态。这里有两个生产环境必须注意的细节:第一,重新认证。API Gateway 在 `$connect` 路由(即客户端建立连接时触发的那条路由)上做鉴权,故障转移后备区域会用 Lambda authorizer(自定义鉴权函数)重新验证客户端身份,所以这份鉴权函数必须在两个区域都部署。第二,从验证后的 token 里拿到用户标识(比如 JWT 的 `sub` 声明,即唯一标识用户的那个字段),用它作为状态存储的键。
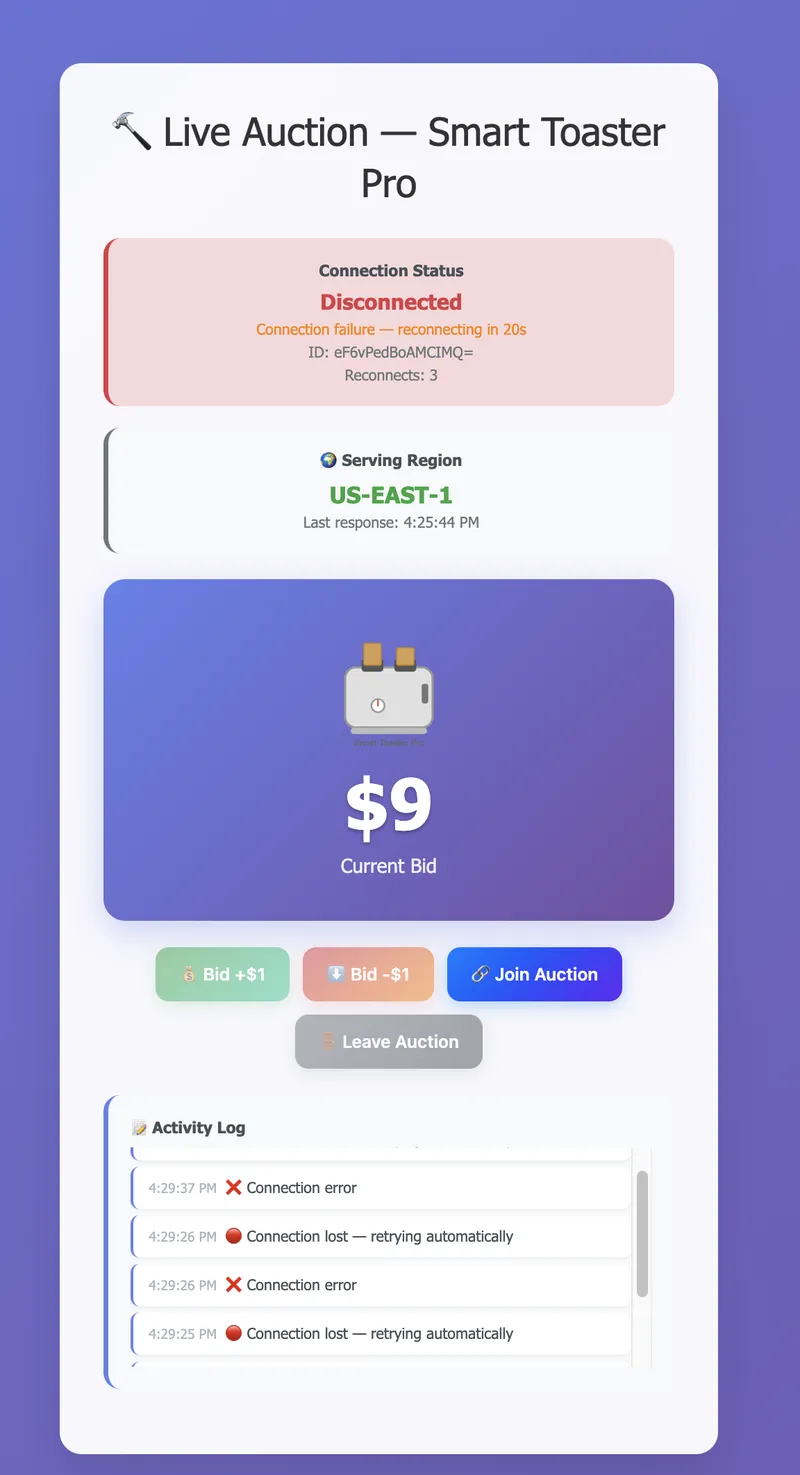
展示了客户端重连和状态恢复的消息时序。
还有一个容易被忽视的细节:心跳机制。无论是客户端还是 canary 探测,都要靠应用层心跳来确认连接活着。文章里的客户端代码用 `react-use-websocket`(一个 React 的 WebSocket 库)配置了心跳:每 30 秒发一条 `heartbeat` 消息,35 秒内没收到 `pong` 响应就判定连接断开,触发重连。canary 用同样的机制驱动 Route 53 健康检查。这套机制是 RFC 6455(WebSocket 协议标准)里的标准做法,任何客户端库都能实现,不依赖特定框架。
架构本身不复杂,但有几个坑要提前知道。DynamoDB Global Tables 是异步复制,故障发生前最后一两秒的写入可能没来得及同步到备区域,对大多数应用这个窗口可以接受,对强一致敏感的场景就需要额外设计。如果改用关系型数据库做状态存储,比如 Aurora Global Database(AWS 的托管关系数据库,支持跨区域复制),虽然复制延迟可低至亚秒级,但故障转移时需要把只读副本提升为主库,这个过程通常要 1-2 分钟,比 DynamoDB 的“即读即用”慢不少,而且提升过程也能用 CloudWatch 告警自动触发。
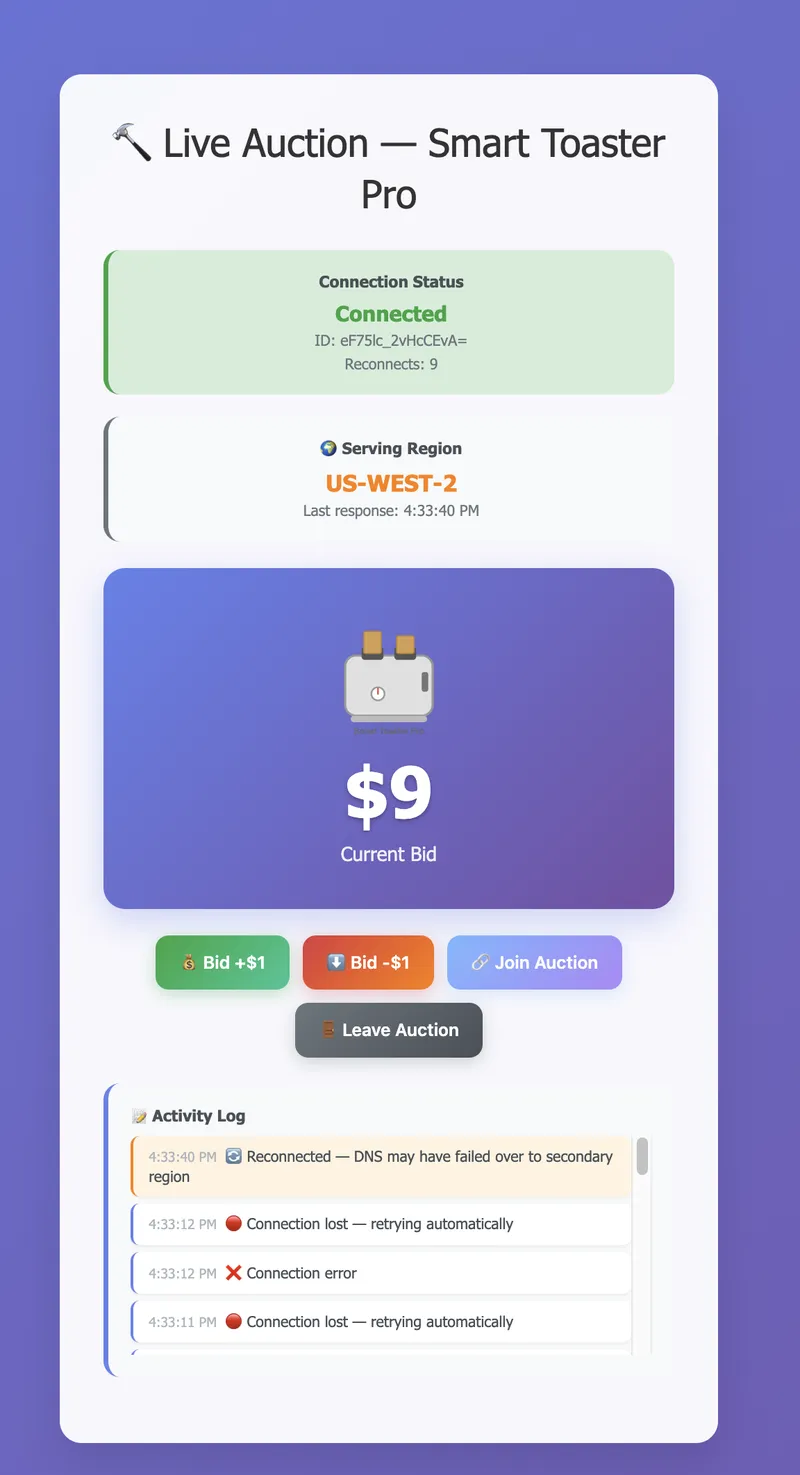
对比了不同状态存储方案的恢复时间。
这套模式的启示不仅限于 AWS。任何需要高可用的实时系统都可以借鉴:把连接和状态分离、用独立探针检测故障、让客户端具备自动重连和状态拉取能力。哪怕你不做跨区域,单区域内做多可用区部署,这个思路一样适用。核心是别让连接本身成为状态容器——连接断了大不了重连,状态没了才是真正的灾难。
内容与图片版权归原作者所有 · 原文: https://aws.amazon.com/blogs/architecture/multi-region-disaster-recovery-for-amazon-api-gateway-websocket-apis/