 devgo.cn
用过 Claude Code 或类似 AI 编程助手的开发者,大概率都遇到过同一个痛点:让 Agent 去查一个函数定义、找一处配置来源,它会把整个文件甚至好几个文件读进上下文,然后这些内容会一直留在会话里,占用宝贵的 context window,还让后续每一轮对话都变得更慢、更贵。你只是想知道 flyTo 的动画时长是怎么算的,它却把 camera.ts 整个读了一遍,这些中间产物在回答完问题后毫无用处,却要跟着你走完整个 session。
Ototo 这个开源项目换了个思路:既然大部分代码探索本质上是“查资料”,而不是“思考”,那为什么非要让主 Agent 亲自去翻文件?它把探索这件事拆出来,交给一个更小的模型去干。你的主 Agent(比如 Claude)只需要把问题抛给 Ototo,Ototo 会启动一个跑在你指定服务器上的小模型,让它用只读工具去读代码、搜仓库、查引用,最后带回一个简短的答案,并且附上经过核验的代码行引用。小模型探索过程中产生的所有中间上下文,在回答返回后就被丢弃,不会污染主 Agent 的 context。
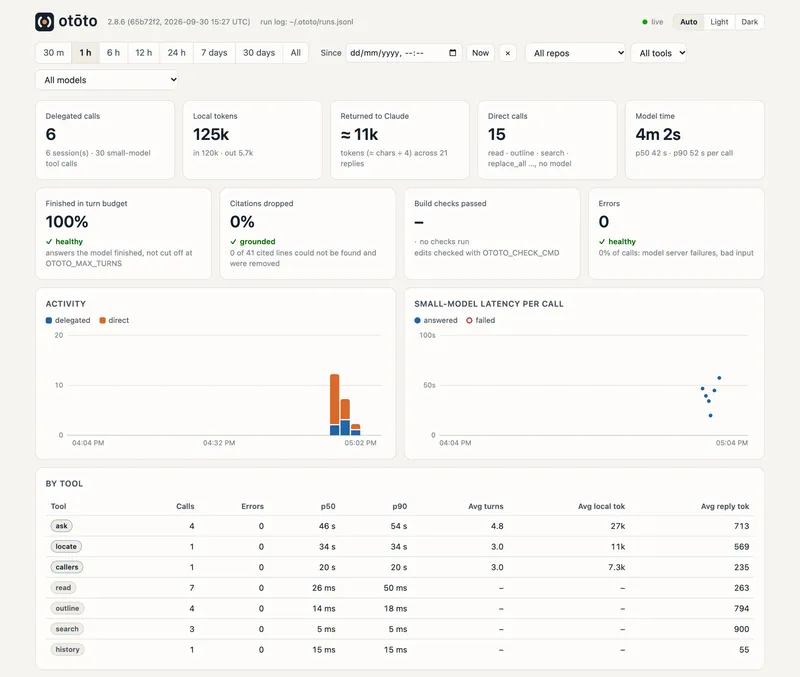
这个架构最巧妙的地方在于它区分了两种不同类型的请求。有些问题确实需要模型的理解能力,比如“这个模块的 NAT 网关数量是怎么决定的”,这种问题交给小模型去读代码、总结逻辑是合理的。但还有大量请求根本不需要模型,比如“DOWN_FOR 这个常量在哪里定义”“谁调用了 request 这个函数”“某个 commit 改了哪些函数”。Ototo 为这类纯查找操作提供了直接的工具,直接从文件系统和 git 里拿答案,连模型都不用启动。一个 `ototo read src/ototo/agent/llm.rs#brief` 就能按名字取出某个函数及其行号,一个 `ototo changes --commit 907d144` 就能告诉你这个 commit 动了哪些声明,全程零模型调用,速度自然快得多。
从实际效果看,这个分工带来的收益很直观。文章里展示的几个真实查询,小模型处理一个问题大概消耗 11k 到 20k tokens,耗时 18 到 47 秒。作为对比,如果让主 Agent 自己探索,光是 grep 加读文件就可能读进 2600 行代码,这些内容会一直留在上下文里。用 Ototo 之后,主 Agent 的上下文里只多了一段话和几行引用,剩下的空间可以留给真正的任务逻辑。如果你用的是按 token 计费的模型,省下来的上下文直接就是省下来的钱;如果你在本地跑开源模型,那省下来的是宝贵的显存和推理时间。
Ototo 还考虑了企业环境里常见的复杂构建场景。它支持插件机制,插件以 WebAssembly 形式运行,经过签名和沙箱隔离。比如读 `pom.xml` 时,普通文本读取只能看到 `${spring.version}` 这种占位符,但 Maven 插件能解析出实际生效的版本号;读 JAR 包时,插件可以直接展开里面的 class 文件,按声明结构展示,不用先解压再 javap。每个插件有独立版本,`ototo plugins update` 可以单独升级,不影响主程序。
这个思路对任何重度使用 AI 编程助手的人都有直接借鉴价值。核心启发是:不要把所有事情都塞给大模型,把“探索”和“思考”分开,探索交给便宜快速的小模型或干脆用确定性工具,思考留给主 Agent。这不仅能省 token、省时间,更重要的是让主 Agent 的上下文保持干净,减少它在长会话中“忘记”前面内容的风险。如果你正在做 Agent 相关的工具链设计,Ototo 的“主 Agent 提问、小模型探索、引用核验返回”这个模式值得参考;如果你只是日常用 Claude Code 写代码,也可以考虑接入这类工具,把那些纯查找类的请求从模型调用里剥离出去。需要注意的坑是:小模型的能力上限决定了它能处理的探索复杂度,如果问题涉及非常隐晦的跨文件逻辑,小模型可能给不出准确答案,这时候还是得让主 Agent 亲自下场。
内容与图片版权归原作者所有 · 原文: https://ototo.dev/