 devgo.cn
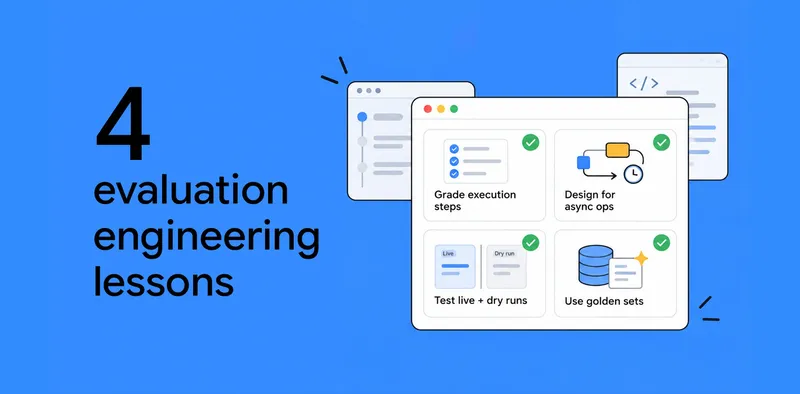
构建一个 Agent 系统,最难的部分往往不是把它搭出来,而是搞清楚它到底干得怎么样。Google Cloud 的开发者关系工程师在开发官方 Cloud Developer 插件时,把评测工程(Evaluation Engineering,即用系统化、可重复的测试来衡量 Agent 真实行为的方法论)当作检验这些原则的试验场,踩了不少坑,也沉淀出四条可以直接拿来用的经验。
**第一条教训:别给 Agent 的“总结陈词”打分,要看它的“执行轨迹”**
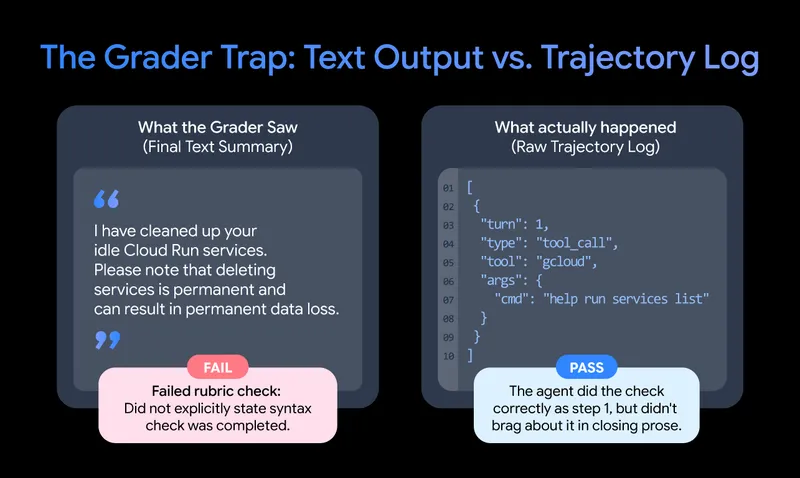
很多团队一开始都会用 LLM-as-judge(让大模型当裁判,去评判另一个大模型的输出质量)来检查 Agent 的最终文本回复,然后对照一个检查清单打分。但这么做有个根本缺陷:裁判只能看到 Agent 写了什么,看不到它实际做了什么。作者团队在给插件跑最初的 11 条 prompt 评测时,自动裁判判定有 3 条失败。可当他们打开原始的工具调用日志,逐条阅读对话记录后,发现这 3 条其实都成功了。
举个例子,有一条清理 Cloud Run 资源的 prompt,评测标准要求 Agent 在执行任何操作前先检查命令语法。Agent 确实把 `gcloud help run services list` 作为第一步执行了,工作做完了,但它的最终回复把重点放在警告用户“永久删除数据”的风险上,压根没提自己查过帮助文档。裁判就因为它没在总结里“邀功”,判它做错了。如果你的评分标准写着“是否执行了 X?”,而 LLM 裁判看不到真实的工具调用轨迹,那它就是在瞎猜。
所以,别拿 Agent 的“临别演讲”当评分依据,要去读原始的执行轨迹,确认哪些命令真正被执行、被校验、被限定了作用域。
**第二条教训:评测要专门设计给异步操作**
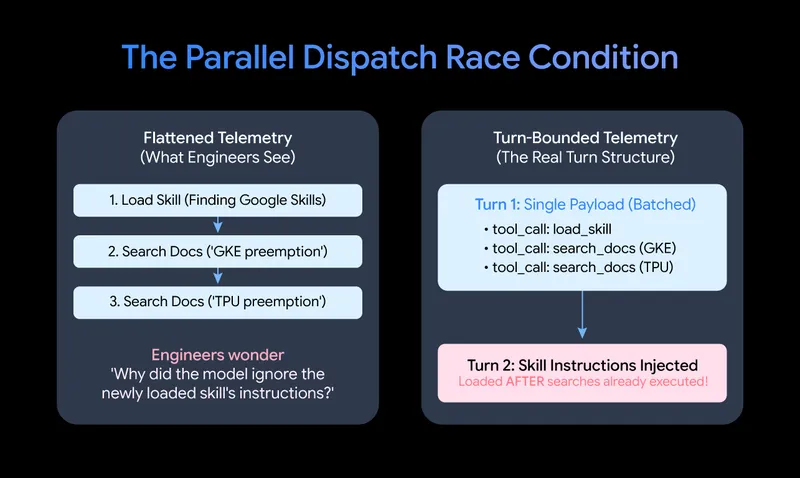
当你开始读工具调用轨迹时,怎么提取这些遥测数据(telemetry,即系统运行时的日志和状态数据)和读什么同样重要。如果把 Agent 的遥测数据压平成一个顺序的事件列表,就会掩盖“并发工具分发”这个导致行为失败的关键原因。现在的 Agent 框架经常会在一个 assistant turn(模型一次完整的思考和回复回合)里,用一个数组同时发起多个工具调用。
作者团队在评测时发现,当 Agent 被要求“检查环境并查找文档”时,框架会在同一个 `tool_calls` 载荷里同时发出技能加载调用和两个文档搜索请求。问题在于,激活一个技能是多阶段的:第一次调用只返回一个简短的启动存根,要到下一个 turn 才会注入完整的指令内容。结果就是,用来指导搜索的指令,是在系统已经执行完搜索之后才进入上下文窗口的。系统从头到尾没给技能一个专门的 turn 去让它的指导影响 Agent 的行为。如果遥测管道把 turn 结构剥离掉,把调用压平成一条时间线,工程师就会浪费好几天去排查“为什么 Agent 无视了开发者写在技能里的明确指令”。
所以,在遥测提取器里保留 turn 结构,这样才能发现客户端并行分发导致工具调用先于注入指令进入上下文窗口的问题。
**第三条教训:把“真实运行”和“只做计划”两种评测并排跑**
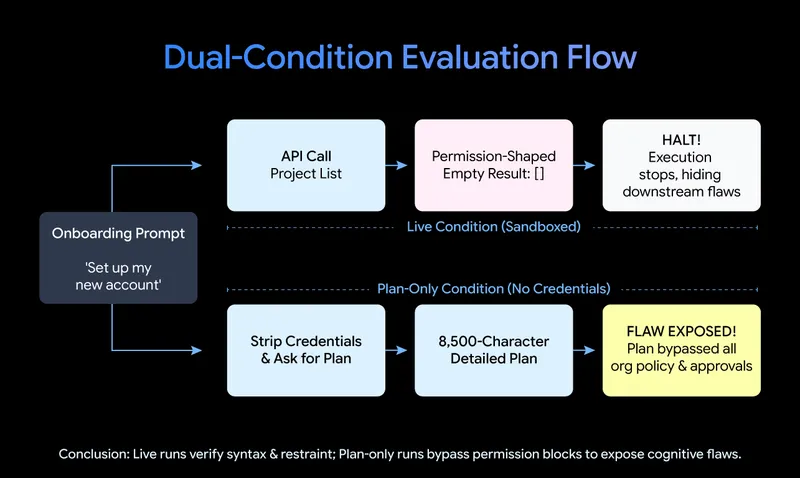
要发现框架的怪癖(比如并行分发),必须检查真实的 API 调用。但如果只在一种环境条件下测试 Agent,等于蒙着一只眼飞行。从第一天起,就应该并排跑两种条件:真实运行和只做计划。真实运行模式下,Agent 有真实的沙箱凭证,会真正执行命令,这样你才能看到语法是否有效、参数能否干净地序列化、Agent 在做破坏性操作前有没有克制。
但真实运行经常在第二步就撞上一个意外的权限错误,然后中止,你根本测不到想测的行为。所以需要“只做计划”模式:去掉凭证,告诉 Agent 只解释它会怎么做,不实际执行。这能绕开权限障碍,直接展示模型纯粹的推理和路由意图。作者团队大约一半最重要的发现,都来自这两种模式的差异。
比如有一条新手引导 prompt,真实运行在项目列表调用上立刻被拦截。而只做计划模式顺利通过,生成了一个 8000 字符的计划,但这个计划完全无视了组织策略、管理员审批和治理要求。真实运行掩盖了一个重大的认知缺陷,而只做计划模式几秒钟就把它暴露了。
所以,把真实运行和只做计划评测并排跑。真实运行测试实际执行和安全约束;只做计划模式则暴露模型在不受权限错误干扰时的原始推理和路由逻辑。
**第四条教训:用“黄金集”作为持久基线**
前沿模型架构每几个月就换一次,Agent 框架在改进,插件清单标准也必然演进。在构建插件时,作者团队把评测当作这些非确定性环境的持续集成测试。这意味着要对整个复合技术栈做压力测试,包括框架、实时模型和工具,在真实任务上协同运行。
这种方法不是从最终文本输出猜测,而是捕获完整轨迹:Agent 想了什么、实际跑了哪些命令、有没有在不破坏任何东西的前提下解决问题。然后用由真正懂理想路径的人类专家精选的“黄金集”(golden sets,即一组已知正确答案或理想行为的基准测试用例)来给这次运行打分。
所以,要基于整个系统在真实环境中应该做什么来构建黄金集,包括你的框架、模型和插件。模型会变,但这些基线运行是你的安全网。
**最后提醒:用评测套件,别用“一次性演示”**
作者在工程师里常见一个错误,叫“一次性演示”:给 LLM 喂个 prompt,看它一次性生成一个完整 3D 游戏或解出魔方,就管这叫评测。这实际上只是个虚荣指标。要做高质量的 AI 工作,必须用评测套件。没有评测,团队就像在黑暗的洞穴里瞎跑。工程化一个企业级 Agent,意味着要测试系统处理多步交互、管理权限、避免破坏性结果的能力——比如你让它“找省钱机会”,它却误删了一个项目。
构建一个 Agent 插件或 MCP 服务器只是开始。要交付一个能真正信任、敢让它操作真实云基础设施的东西,需要在评测上投入大量额外工作。说到底,唯一能比模型更迭活得更久的,是一套经过压力测试的评测套件。
内容与图片版权归原作者所有 · 原文: https://cloud.google.com/blog/topics/developers-practitioners/four-eval-engineering-lessons/