 devgo.cn
搜索和推荐场景想用语言模型提升在线效果,最大的拦路虎是延迟。通用大模型推理引擎(比如 vLLM、SGLang)是为开放式文本生成设计的,它们假设请求的 decode 次数无上界、prefill 长度任意变化,调度策略围绕这些假设做了大量优化。但搜推场景的 SLM 负载完全不是这样:请求要么只做一次 prefill 就出结果(Prefill-Only),要么做固定次数的 decode(Beam Search),输入长度、beam 宽度、生成步数在部署前就能确定上界。用通用引擎跑这种负载,等于开着卡车去送外卖——大量为长文本生成设计的机制在这里全是负优化。美团的做法是彻底抛弃通用引擎,为这类「有界生成负载」从零设计了一套以静态 DAG 为执行抽象的推理框架,在平均端到端延迟低于 20ms 的约束下,Prefill-Only 有效 MFU 达到 67%,吞吐比 SGLang 提升 10 倍。
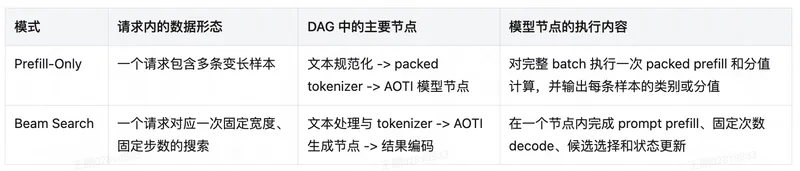
先看这类负载到底有什么特殊。搜推场景用的 SLM 参数量通常在 0.5B 到 1B 之间,结构还是 Decoder-only Transformer,但执行形态和 ChatGPT 那种对话完全不同。Prefill-Only 模式只执行一次 prefill,根据每条序列最后一个有效 Token 位置的 logits 得到分类分值或 embedding,不进入自回归 decode。Beam Search 模式执行一次 prefill 加固定次数 decode,在固定 beam 宽度下返回少量候选序列。两类请求的输入规模、运行状态、最大迭代次数都有预先确定的上界,这就是所谓的「有界生成负载」。
为什么通用引擎在这里表现糟糕?作者用排队论里的 G/G/1 模型做了分析。GPU 推理本质是串行计算,推理耗时可以抽象为排队模型,关键指标有三个:ρ 表示 GPU 在 1000ms 内执行计算的时间占比(拥挤程度),c_a 是请求到达间隔的变异系数,c_s 是服务时间变异系数。搜推场景下,由于序列分批处理,请求到达间隔严重偏离泊松分布,c_a 很大;但服务时间相对稳定(序列长度和 batch size 基本固定),c_s 较小。通用引擎的调度策略无法处理严重偏离泊松分布的到达负载,而它为了无界生成设计的各种优化(比如动态 batching、continuous batching、prefix cache)在这里全是负向优化。结果就是 GPU 利用率很低但耗时很高——请求在 GPU 入口排队,超时后被丢弃,GPU 反而空转。
作者的思路很清晰:既然 c_s 小,就移除通用引擎为无界生成设计的优化,重新为有界负载设计 GPU 计算路径,目标是减少单次 forward 的平均耗时 τ;同时移除 Python 对 request 和 token 的调度开销,压缩 CPU 等待与处理时间;再用 C++ 精细化的 Multi-Stream 调度增加 GPU 跨请求并行能力,缓解 c_a 无法调和的问题。
具体实现是一套分层编译执行架构。离线构建链用 Python 表达模型语义,通过 AOTInductor 把完整 GPU 计算编译成可直接加载的 AOTI 节点产物;在线执行链用 C++ 完成协议处理、DAG 调度、资源管理和数据转换,不再解释或即时构建模型计算。核心是把「完整业务请求」作为 DAG 调度、端到端测量和容量规划的共同边界。
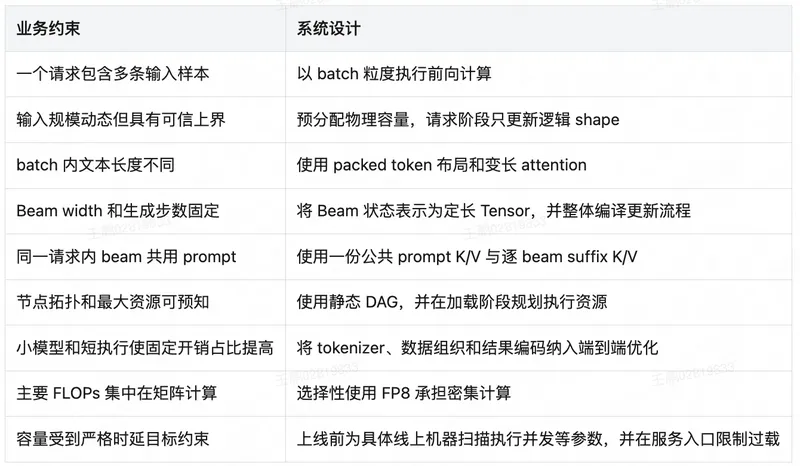
这个设计的关键在于执行粒度的选择。早期方案用 Triton Inference Server 的 Python Backend 适配业务协议,配合 SGLang 执行模型,批量输入会被拆成多条独立生成请求,Beam Search 的每个 decode step 也走通用生成控制路径。这种粒度适合开放式生成,但对有界负载来说,请求拆分、对象创建、进程通信、逐步控制、结果重组这些固定开销都要在 20ms 的端到端预算内完成,模型计算根本摊薄不了。新方案里,Prefill-Only 请求内部的多条样本作为一个 batch 进入模型节点,不再拆分;Beam Search 从 prompt prefill 到最终候选返回只经历一次 DAG 调度。
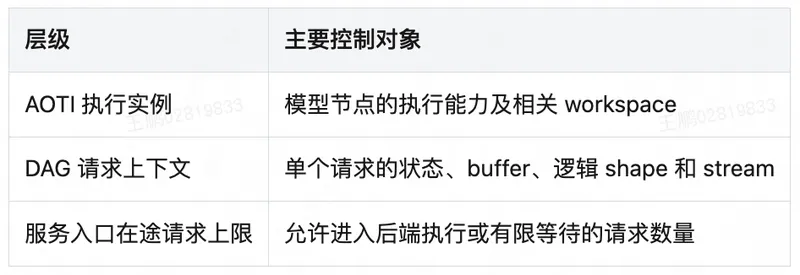
静态 DAG 固定的是执行结构和物理资源边界,不要求 shape 完全固定。加载阶段确定节点拓扑、跨节点 Tensor 类型、最大物理容量、最大迭代结构;请求阶段动态确定实际 batch 大小、有效 Token 数、逻辑 shape。这样既保留了业务动态性,又能在加载阶段预分配 buffer 和 stream,请求热路径只处理有效数据。
最让我意外的是固定 Beam Search 的单节点编译。作者把有限次数的状态转移表达为结构确定的 Tensor 程序,把搜索控制从在线 Runtime 移入模型程序。开放式生成系统需要在 decode step 边界重新组织请求状态、决定下一轮执行对象;但这里搜索深度固定,这部分控制可以完全编译进模型节点。每一步维护的 logits、候选 token、累计分数、parent index 都变成 Tensor 程序里的固定操作,在线 Runtime 只负责调用节点,不需要理解内部搜索逻辑。
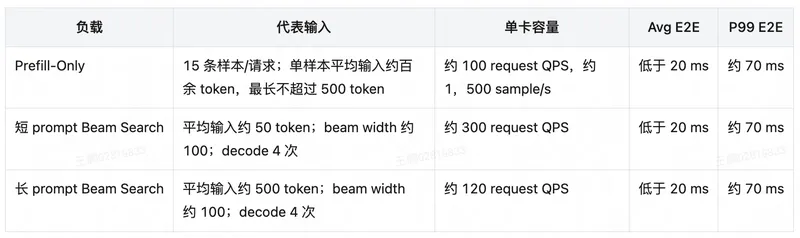
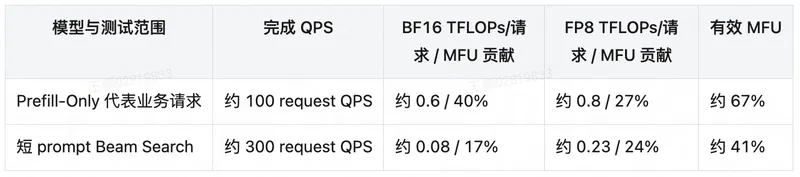
性能数据很能说明问题。约 0.6B 的 Prefill-Only 模型,每个请求含 15 条样本时达到约 100 request QPS(约 1500 sample/s);约 0.5B 的短 prompt 和长 prompt Beam Search 模型,beam width 约 100、decode 4 次时,分别达到约 300 和 120 request QPS。三类负载平均端到端延迟均低于 20ms,P99 约 70ms。Prefill-Only 负载下混合精度有效 MFU 为 67%,约为 SGLang 的 10 倍;短 prompt beam search 有效 MFU 41%,约为 SGLang 的 6 倍。
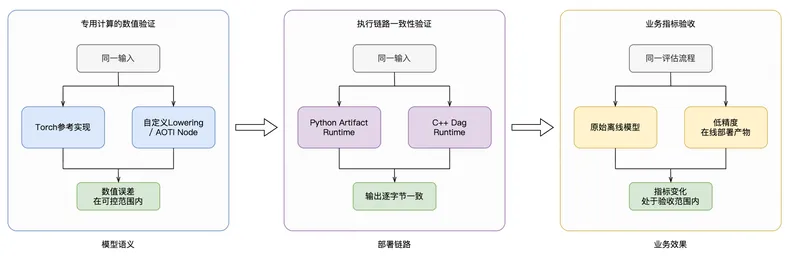
这套思路能直接借鉴的场景很明确:凡是请求执行结构固定、动态 shape 可控的在线推理负载,都可以考虑抛弃通用引擎,按「静态 DAG + 编译执行」的思路重写。比如意图识别、文本分类、相似度计算、生成式召回这类任务,输入长度有上界、输出是固定维度的向量或少量 token,用通用引擎反而被拖累。要注意的坑是:这套方案依赖对负载特征的深度理解,如果业务请求的 decode 次数、beam 宽度、输入长度没有明确上界,静态 DAG 的容量预分配就会失效;另外,AOTInductor 编译产物对模型结构变化不友好,模型迭代时需要重新走编译流程,工程上要预留好构建链的自动化。
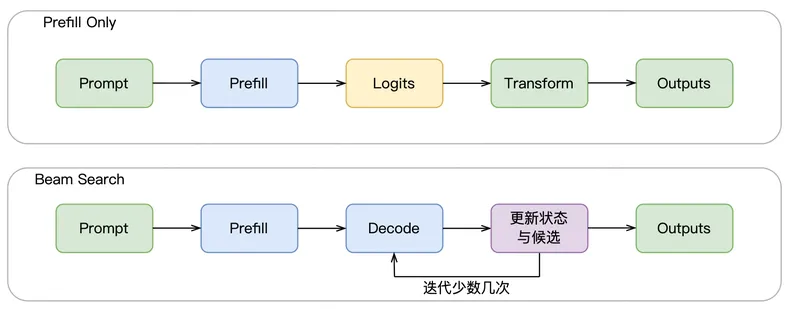
搜推场景的 SLM 负载和开放式文本生成在在线执行形态上有本质差异。Prefill-Only 只做一次前向,Beam Search 做固定次数 decode,两者的输入规模、状态容量、最大迭代次数都能在部署前确定。
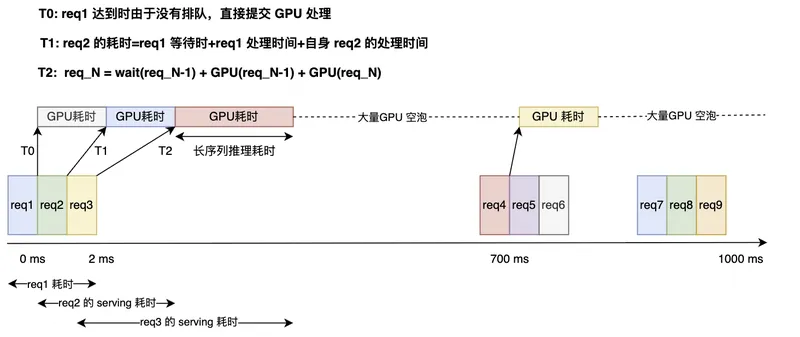
通用推理引擎的调度策略假设请求到达符合泊松分布、decode 次数无上界,这些假设在搜推场景下全部失效,导致 GPU 利用率低但延迟高。
系统整体架构分为离线构建链和在线执行链。离线用 Python 表达模型语义,经 AOTInductor 编译为 AOTI 节点产物;在线用 C++ 完成协议处理、DAG 调度和资源管理。
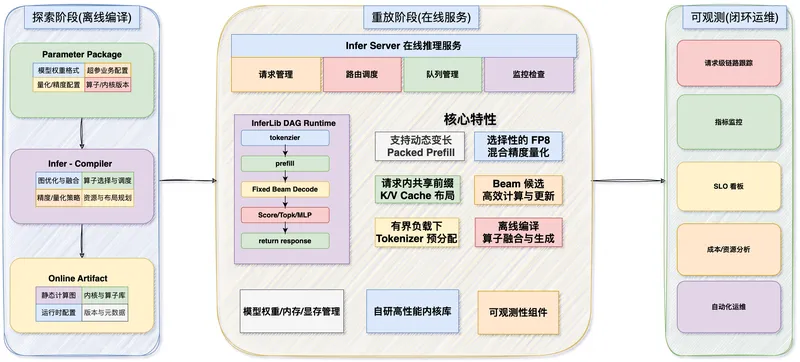
Prefill-Only 和 Beam Search 两类模型对应两张不同的静态 DAG。Prefill-Only 的多条样本一次进入模型节点,Beam Search 的各个 decode step 在生成节点内部完成。
早期执行路径中,批量输入被拆分为多条独立生成请求,经过通用生成 Runtime 逐步控制,再重组结果;当前执行路径以完整业务请求为边界,一次 DAG 调度完成全部处理。
静态 DAG 的节点执行模型分层:DAG Runtime 调度节点,节点通过 CPU Engine 或 AOTI Engine 执行具体计算,模型拓扑和搜索状态封装在节点内部。
固定 Beam Search 的状态转移被编译为结构确定的 Tensor 程序,在线 Runtime 不再需要理解搜索逻辑,只需调用编译好的节点。
性能对比:Prefill-Only 负载下混合精度有效 MFU 67%,约为 SGLang 的 10 倍;短 prompt beam search 有效 MFU 41%,约为 SGLang 的 6 倍。
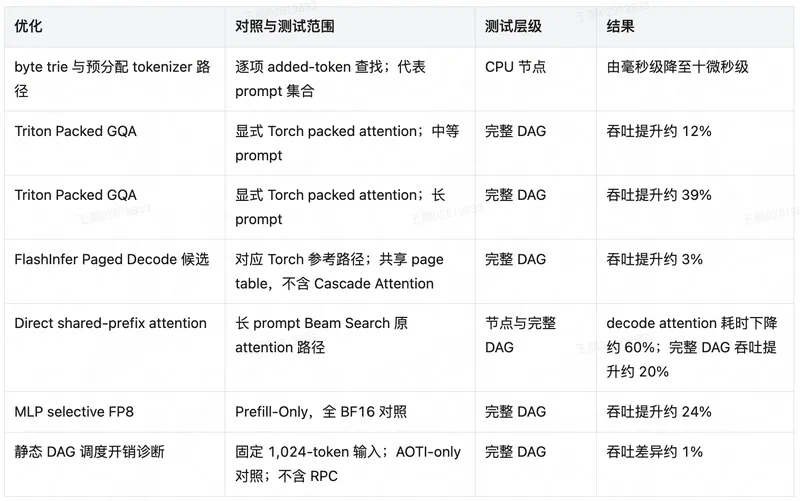
三类负载的平均端到端延迟均低于 20ms,P99 约 70ms,满足搜推场景的在线延迟约束。
该框架已在美团搜索意图分流、相关性判断、生成式召回等场景取得实验显著性,支撑业务在推理成本可控的情况下全量推送。
内容与图片版权归原作者所有 · 原文: https://tech.meituan.com/2026/10/15/Small-Language-Model-in-meituan.html