 devgo.cn
你在模型卡片上见过多少次“1M context window”?数字越来越大,但你心里其实没谱——1M token 到底能装下什么?是一个超长提示词,还是一本《三体》全集?一个名叫 One Million Tokens 的交互网站,把这一百万 token 画成一摞物理纸堆,然后从 2020 年一路滚动到今天,让你直观看见上下文窗口六年的暴涨曲线。这篇文章不仅讲了网站本身,更点破了一个容易被忽略的事实:上下文长度是桌子的尺寸,推理质量才是用桌子的人的水平。
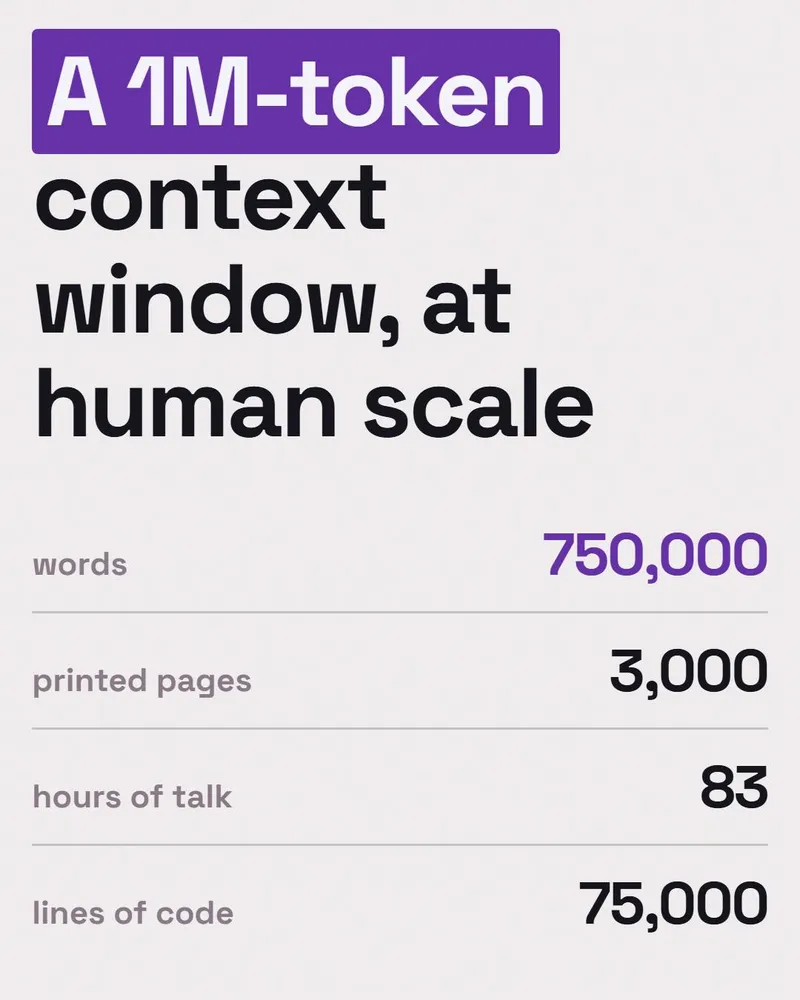
先给个直观换算。网站给出的近似值是:约 3000 页印刷纸、约 83 小时的对话、约 75000 行代码。注意这些只是直觉泵,不是通用常数——不同内容的 token 化差异很大,但数量级是对的,它确实能让你瞬间明白:百万 token 不是“长一点的提示词”,而是一间小型图书馆。
时间线的起点是 2020 年 6 月的 GPT-3,只有 2048 token,画出来大约 6 页纸。然后 2022 年 11 月 ChatGPT 是 4096,2023 年 3 月 GPT-4 32K 是 32768,2023 年 5 月 Claude 到了 100000。
这条曲线在 2023 年之前几乎是平的,直到 2024 年 2 月 Gemini 1.5 Pro 冲过百万 token 大关,那才是第一次让百万级上下文从研究结果变成可购买的商品。网站把完整时间线一直延伸到 1000 万 token,对比 GPT-3,六年里前沿模型的“工作记忆”增长了约 3.5 个数量级。曲线比倍数更直观:前面几年几乎是零增长,然后突然撞上一堵墙,垂直起飞。
这个增长对软件工程意味着什么?上下文长度决定了一个模型一次能“看”多少代码:从一小段片段或短对话,到单个大文件或几个文件,再到一个完整子系统,甚至到大型代码集合、接近仓库级的输入。

网站把 75000 行代码作为参照,假定每行约 13 个 token。但这不是仓库容量公式——Python、压缩后的 JavaScript、JSON、注释、生成代码、强类型语言的 token 化方式差异巨大,实际行数可能大幅偏离。
那更大的窗口是不是就淘汰了 RAG(检索增强生成,就是先从外部知识库搜出相关片段再喂给模型的技术)?这个问题的答案很微妙。作者明确指出:RAG 承担的不只是“塞不下”这一个功能。它还能过滤无关材料、降低输入成本、独立更新源数据。百万 token 窗口意味着你可以塞进更多源材料,但“能塞”不等于“应该全塞”。容量是能力边界,不是承诺。
最值得点名的一个误区是:容量不等于理解。
一个拥有 1M 窗口的模型照样可能:漏掉提示词里出现的事实、根据事实所处位置表现不同、跨文档推理能力下降、输入越大越慢越贵、对某些细节的检索能力远好于其他细节。长上下文基准测试存在的意义就是为了检验模型是否真的“用”了这个窗口,而不是说 tokenizer 能接受就算完事。
作者反复提到的那个框架特别好用:上下文大小 = 桌子的尺寸,推理/检索质量 = 模型在桌上干活儿的水平。
一张更大的桌子有帮助,但它不会让工人变得更聪明。
关于换算,网站的基础假设是:1 页约 333 token,所以一百万 token 对应 3000 页;83 小时对话是按每分钟 150 个口语词估算的。真实文档、tokenizer、语言各有不同,这些只是参照点。网站上还有一个过滤功能,按时间线筛选不同模型,能清楚看到长上下文能力如何从封闭的前沿 API 扩散到开源权重模型。网站作者是 Together AI 的 Hassan。
下次有人再问“百万 token 上下文到底是什么意思”,与其丢一张规格表,不如甩给他这个网站,让他滚动那三千页纸感受一下规模。但更重要的是记住:窗口只是给你更大的一张桌子,模型能不能在上面高效工作,是另一回事。实际工程里,别因为窗口大了就无脑把整个仓库灌进去——先算一下 token 成本、推理延迟,再决定要不要用 RAG 做减法。真正把百万 token 用出价值的人,不是靠堆量,而是靠知道该放什么、不该放什么。
内容与图片版权归原作者所有 · 原文: https://hackernoon.com/what-does-a-million-token-context-window-actually-look-like?source=rss