 devgo.cn
过去两周,一个叫 Jev 的 AI 模型在技术社区里成了现象级话题。乍看它只是个文本分类器,很多人的第一反应和我一样:分类器而已,我自己都能写一个。但深入了解后,我的看法变了——它确实比我预想的要好用。
要理解 Jev 为什么火,得先搞清楚文本分类这条技术路线的来龙去脉。这 15 年的演进,本质上是在回答一个问题:怎么让机器把一段文字归到正确的类别里?从垃圾邮件过滤到新闻分类,从情感分析到意图识别,这个基础任务贯穿了整个 NLP 发展史。

词袋时代:简单粗暴但有效
15 年前我读研究生那会儿,循环神经网络(RNN,一种能处理序列数据的网络结构,适合文本这种有先后顺序的输入)已经存在了,但大家做文本分类基本都用词袋模型(bag-of-words,把文本拆成词,只统计每个词出现次数,完全不管顺序)。原因很简单:它能把任意长度的自由文本,变成固定长度的向量,这样才能喂给那些经典分类器——朴素贝叶斯、逻辑回归、支持向量机、随机森林、XGBoost 等等。
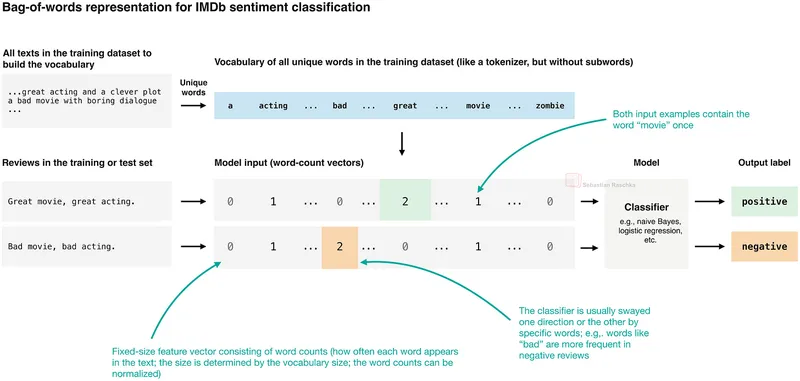
具体怎么做的?先建一个词表,把训练集里所有出现过的词收集起来。假设词表有 5 万个词,那每篇文档就表示成一个 5 万维的向量,每一维对应一个词在这篇文档里出现的次数。不管原文是 10 个词还是 30 万个词,最终都是这个固定大小的向量。当然,绝大多数维度是 0,因为一篇文档不可能包含词表里所有的词。
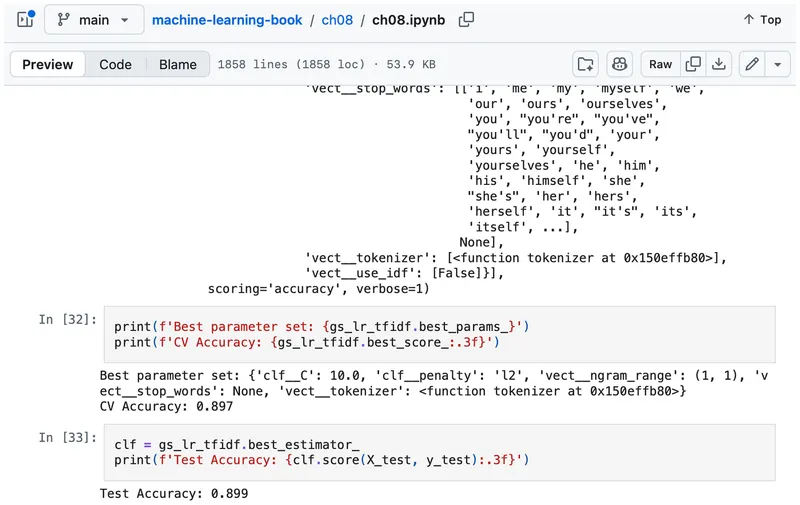
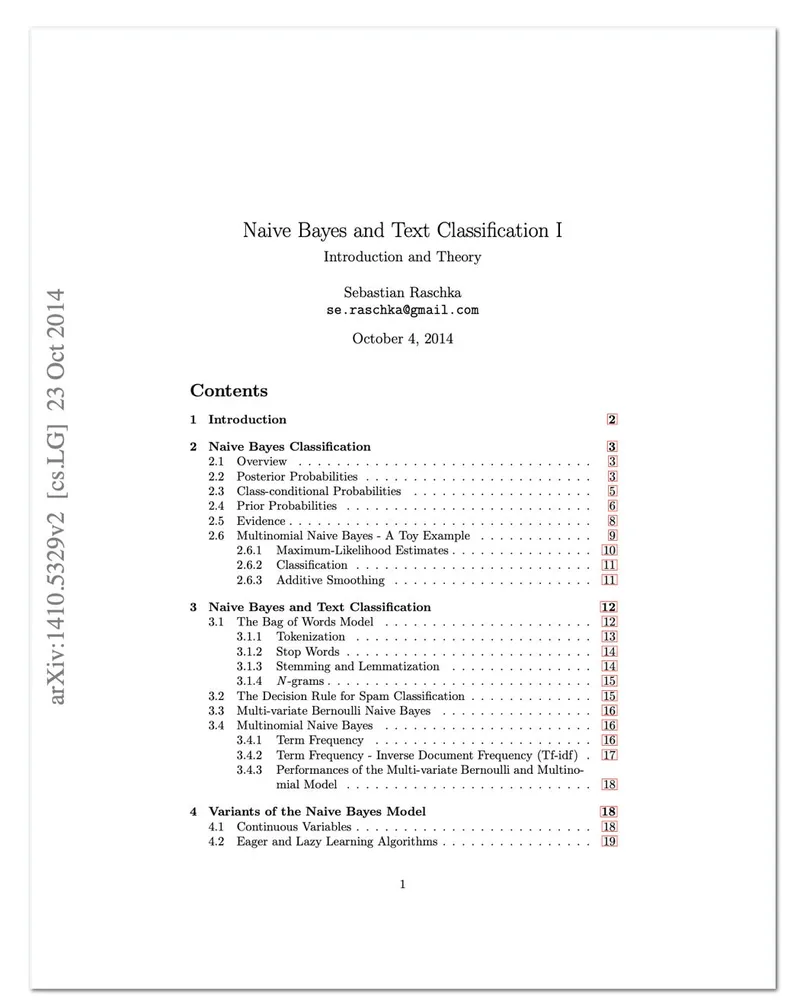
这个方法的经典应用场景太多了:新闻文章分类、邮件垃圾过滤。据说 Gmail 最早的垃圾过滤器用的就是词袋 + 朴素贝叶斯。我自己 12 年前还专门写过一篇 arXiv 论文讲这个。
词袋模型最大的问题在于丢失了词序。"狗咬人"和"人咬狗",在词袋表示下是完全一样的向量,但描述的事件截然相反。虽然可以用 n-gram(把相邻的词对或更长的连续词序列也作为特征)来保留一些局部顺序,但词表会急剧膨胀。
不过说实话,直到今天我依然把"词袋 + 逻辑回归"作为所有文本分类问题的 baseline(基线模型,用来衡量更复杂方法是否真的有提升的参照物)。它太便宜了,实现太简单了,在低风险场景下完全够用。
深度神经网络:从词向量到序列建模
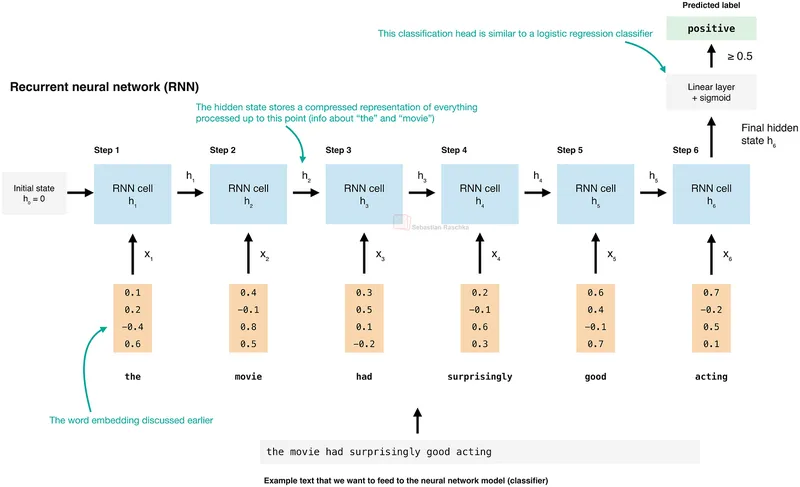
词袋模型也能配合简单的深度神经网络(比如多层感知机,一种最基本的神经网络结构)使用,但同样绕不开词序丢失的问题。真正带来突破的是两类更复杂的网络结构:卷积神经网络(CNN,最初用于图像识别,后来被引入文本处理,通过滑动窗口捕捉局部特征)和循环神经网络(RNN)。它们都能直接吃词嵌入(word embedding,把每个词映射成一个稠密的数值向量,语义相近的词向量距离也近)作为输入。
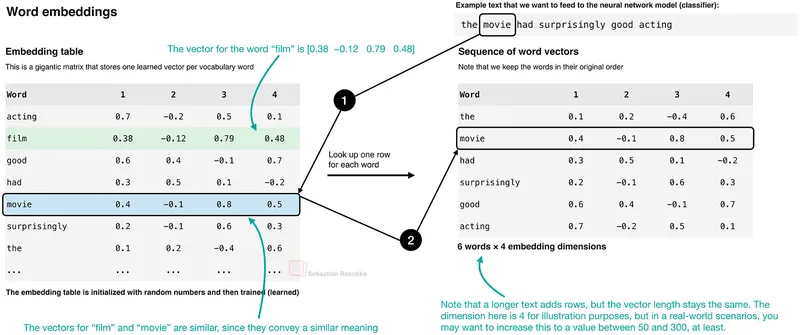
词嵌入和词袋的区别在于:词袋用整个词表的计数来表示整篇文本,而词嵌入是把每个词单独表示成一个稠密向量。这些向量可以是预训练好的(经典方法有 Word2Vec 和 GloVe),也可以作为神经网络的一部分在训练过程中一起学习。但早期的词嵌入有一个局限:它们是上下文无关的。"bank"这个词,在"river bank"(河岸)和"bank account"(银行账户)里用的是同一个向量,语义歧义完全没处理。
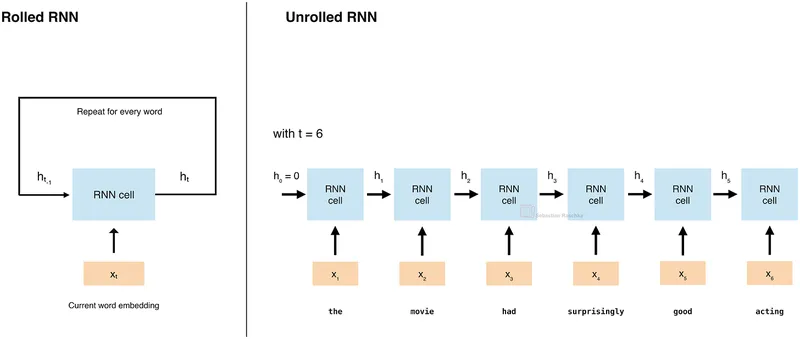
RNN 的出现解决了词序问题。它按顺序逐个读取文本中的词,每一步都保留一个"记忆"(隐藏状态),把之前看到的信息传递下去。但 RNN 有个致命弱点:当文本很长时,早期的信息会在传递过程中逐渐衰减,这就是所谓的"长距离依赖"问题。梯度消失(训练时误差信号在反向传播中逐层递减,导致网络前部的参数几乎学不到东西)让 RNN 很难记住 50 个词之前出现的关键信息。
Transformer:注意力机制带来的范式革命
真正改变游戏规则的是 2017 年那篇《Attention Is All You Need》。Transformer 架构彻底抛弃了循环结构,完全依赖注意力机制(attention,一种让模型在处理每个词时,能动态地关注输入序列中其他相关词的技术)。它让模型可以并行处理整个序列,同时通过注意力权重直接建立任意两个位置之间的联系,长距离依赖问题迎刃而解。
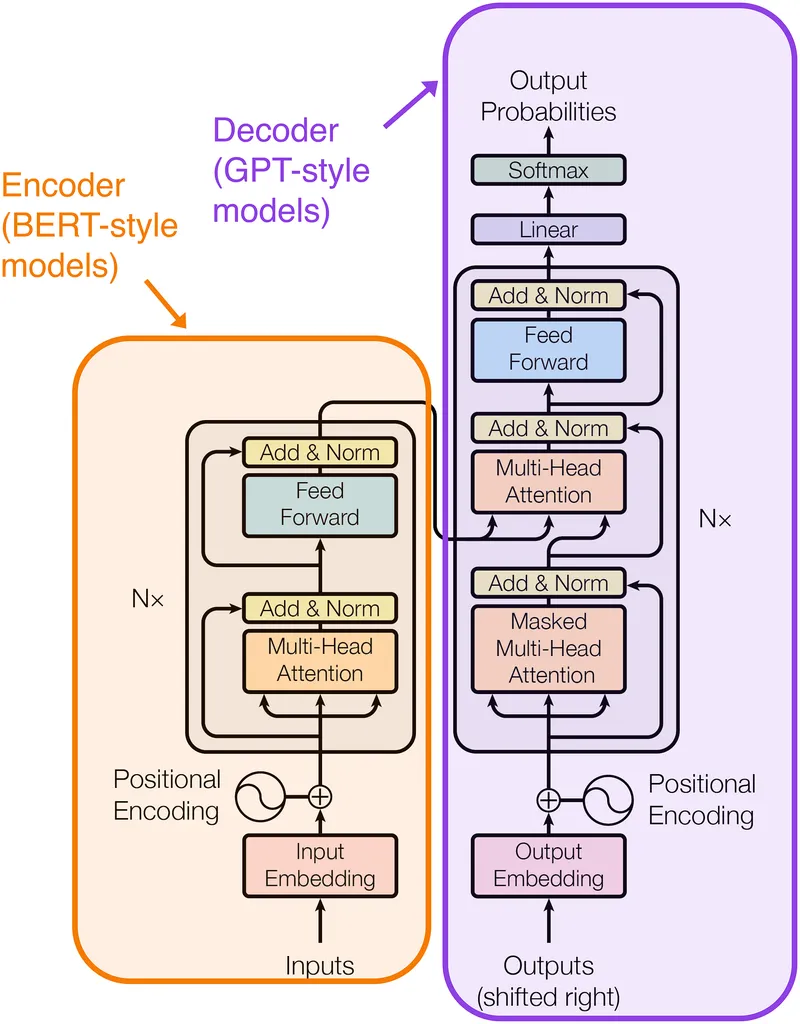
基于 Transformer 的预训练语言模型(先在海量无标注文本上学习语言规律,再针对具体任务微调)迅速成为主流。ULMFiT 证明了迁移学习(把在大规模数据上学到的知识迁移到小规模任务上)在 NLP 中的巨大潜力,而 BERT 则把双向上下文建模(同时考虑一个词前后两侧的语境)做到了极致。
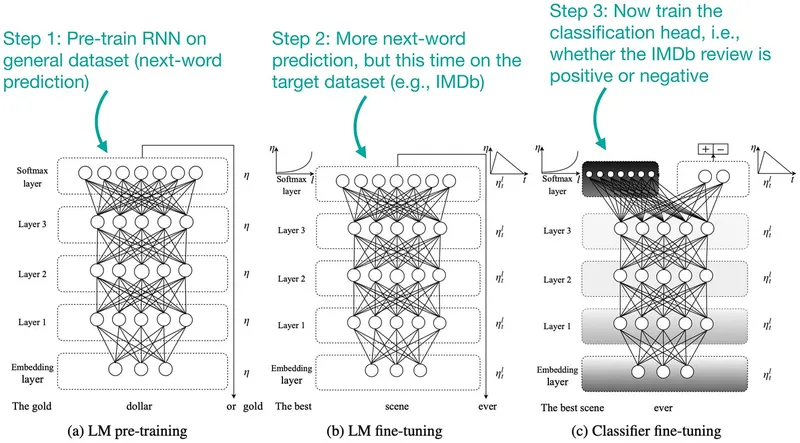
这些模型在分类任务上的表现远超之前的所有方法,但代价是计算量暴涨。一个 BERT 级别的模型做一次推理,需要跑完整个 Transformer 堆叠,延迟和成本都不可忽视。
Jev 的定位:在通用与专用之间找到平衡
现在回到 Jev。它本质上确实是个文本分类器,但它的聪明之处在于找到了一个独特的生态位。
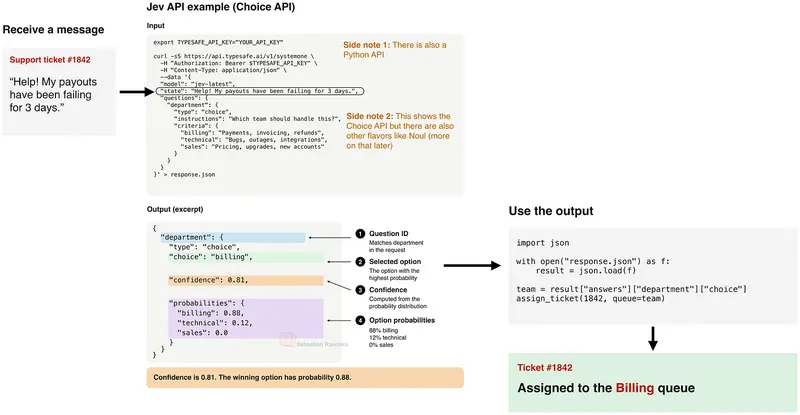
最顶级的 GPT 和开源大模型(LLM,大型语言模型,动辄几十亿甚至上千亿参数)当然能做 Jev 能做的分类任务,而且还能做更通用的决策。但 Jev 的优势在于:它做分类任务的速度快得多、成本低得多。
而在另一个极端,针对某个非常狭窄、定义明确的问题,Jev 的分类准确率、速度、成本大概率都比不上专门训练的特化分类器。但 Jev 的卖点恰恰是:它比那些任务特化模型通用得多。

换句话说,Jev 站在了中间地带:比通用大模型便宜快,比特化分类器灵活通用。这正好填补了那个"用大模型太贵、用特化模型太死板"的空白地带。
对我们有什么启发
回顾这 15 年的演进,最值得记住的一点是:技术选型从来不是越新越好,而是越合适越好。词袋 + 逻辑回归至今仍是低风险场景的可靠选择;RNN 在短序列任务上依然有它的价值;Transformer 统治了需要深度理解的任务;而 Jev 这类模型则提醒我们,在"够用"和"好用"之间,还有大量被忽视的优化空间。
如果你正在做文本分类相关的项目,我的建议是:先跑一个词袋 + 逻辑回归的 baseline,看看数据本身的可分性如何;如果效果不够,再逐步升级到更复杂的模型。同时留意 Jev 这类新工具——它们可能不会在所有指标上碾压你现有的方案,但在成本敏感或需要快速迭代的场景里,可能就是那个更优解。
内容与图片版权归原作者所有 · 原文: https://magazine.sebastianraschka.com/p/classifier-history-and-jev