 devgo.cn
做企业级AI Agent的人大概都踩过同一个坑:用户昨天刚跟Agent说“我只坐直飞航班”,今天回来继续聊行程规划,Agent却把这条硬性要求忘得一干二净。大语言模型本质是无状态的——每次对话都是全新的上下文窗口,不像人类脑子能存住跨天的事。常见的解决办法是“上下文塞满”(context stuffing),把所有历史聊天记录和工具执行日志全堆进prompt里,但问题很快就来了:每多一轮对话,Token费用成倍翻,简单问题的响应时间能拖到30秒以上,更麻烦的是模型会“迷失在中间”(lost in the middle),注意力被海量文本淹没,反而忽略掉最关键的约束条件。
另一个流行方案是滚动式摘要——周期性让LLM把旧消息压缩成一段摘要。这确实能让prompt变小,但LLM摘要天生有损,压缩几轮之后,那些微妙的细节——“航班必须直飞”“酒店预算是每晚不超过300美元”——就被当成背景噪声过滤掉了,Agent在之后的对话里悄悄违反你一开始定好的规则。
Google的工程师在AlloyDB和Memorystore上给出了一个更可扩展的思路:把记忆拆成两层,各司其职。短期层用Memorystore for Valkey(Valkey是Redis的开源替代品,一个内存键值存储)做会话缓冲,缓存当前活跃的对话轮次,用一个受Token上限约束的滑动窗口保持上下文大小稳定;长期层用AlloyDB AI(Google的托管PostgreSQL数据库,内置了向量检索和AI函数)存那些跨会话仍然成立的关键事实和用户偏好。为什么不用单一数据库搞定一切?因为活跃会话缓冲是极其短暂的数据,每一轮对话都要毫秒级地高频读写,如果全写到关系数据库里,会产生大量行删除和垃圾回收压力,拖慢整个库。而短期层的设计目标就是亚毫秒级吞吐,内存缓存天然适合;长期层则要承担事务一致性、数据治理、以及关系型数据与向量混合检索的重任,这正是AlloyDB的强项。
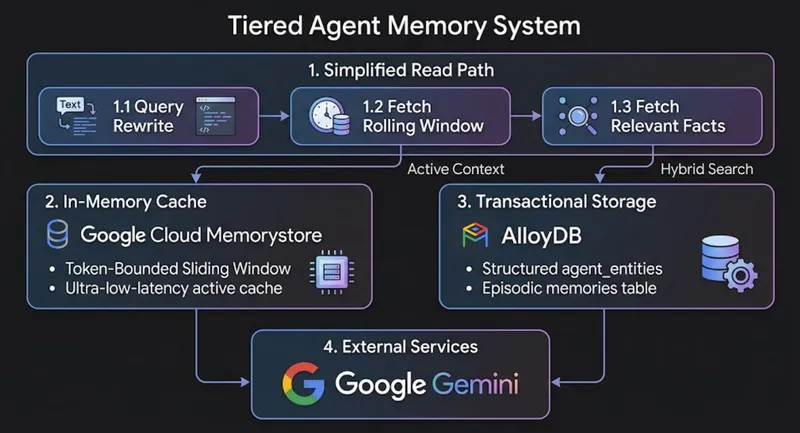
这个分层模型把Agent记忆细分成四种类型:短期对话上下文、长期实体规则、跨会话核心事实、情境式事件记忆(episodic facts)。隔离短期与长期,让Agent按需检索,而不是每次把几万行原始交互日志灌进token窗口。
系统运行时,读写两条通路协同工作:读路径上,用户提问后,应用先从Memorystore取出当前滑动窗口,然后调用AlloyDB的`ai.generate`做查询归一化,再用`ai.hybrid_search`(同时搜索关系和向量)取回范围内实体规则和相关的事件记忆;写路径上,响应生成后立刻写入Valkey缓存,后台异步队列抽取结构化实体写入AlloyDB,事务内自动生成向量嵌入,保证数据一致性。
这个架构带来的商业收益相当直接。Google做了个模拟真实企业AI结对编程助手的测试:45轮以上的多轮开发对话,频繁的工具调用,对比“盲目塞满上下文”的做法,分层存储把Token消耗降低最多70%,响应延迟也显著改善。原因不难理解:prompt大小被控制在固定范围内,不会再随着对话轮次无限膨胀,成本曲线从指数上升变成一条平线。
最让我觉得值得借鉴的,是AlloyDB AI对运维负担的消解。以前做长期记忆,你得自己搭一套embedding生成管道、设计外部调度器、处理重试逻辑。而AlloyDB用`ai.initialize_embeddings`把embedding生成直接内嵌到事务里,源数据一变,向量就在同一事务里自动更新,每秒能生成3000个嵌入,彻底免掉了自定义管线。这些能力虽然藏在数据库里,但实际带来的开发效率提升很可观。
这套双层级记忆思路可以迁移到任何需要跨会话状态的AI应用上:客服机器人、个人助理、代码生成工具。核心要点是:别把所有历史都硬塞给LLM,而是把“临时会话”和“持久事实”分开存,用内存缓存扛高频读写,用数据库保证长期一致性和可检索性。需要注意的坑是异步写入的延迟——如果实体抽取和向量化太慢,可能会出现短期与长期信息不同步的情况,生产环境里得设计好补偿机制。另外,benchmark数据来自内部模拟,实际节省量取决于你的prompt复杂度和查询频率,别直接当绝对值引用。
内容与图片版权归原作者所有 · 原文: https://cloud.google.com/blog/products/databases/implementing-long-term-ai-agent-memory-in-alloydb-and-memorystore/