 devgo.cn
核心观点
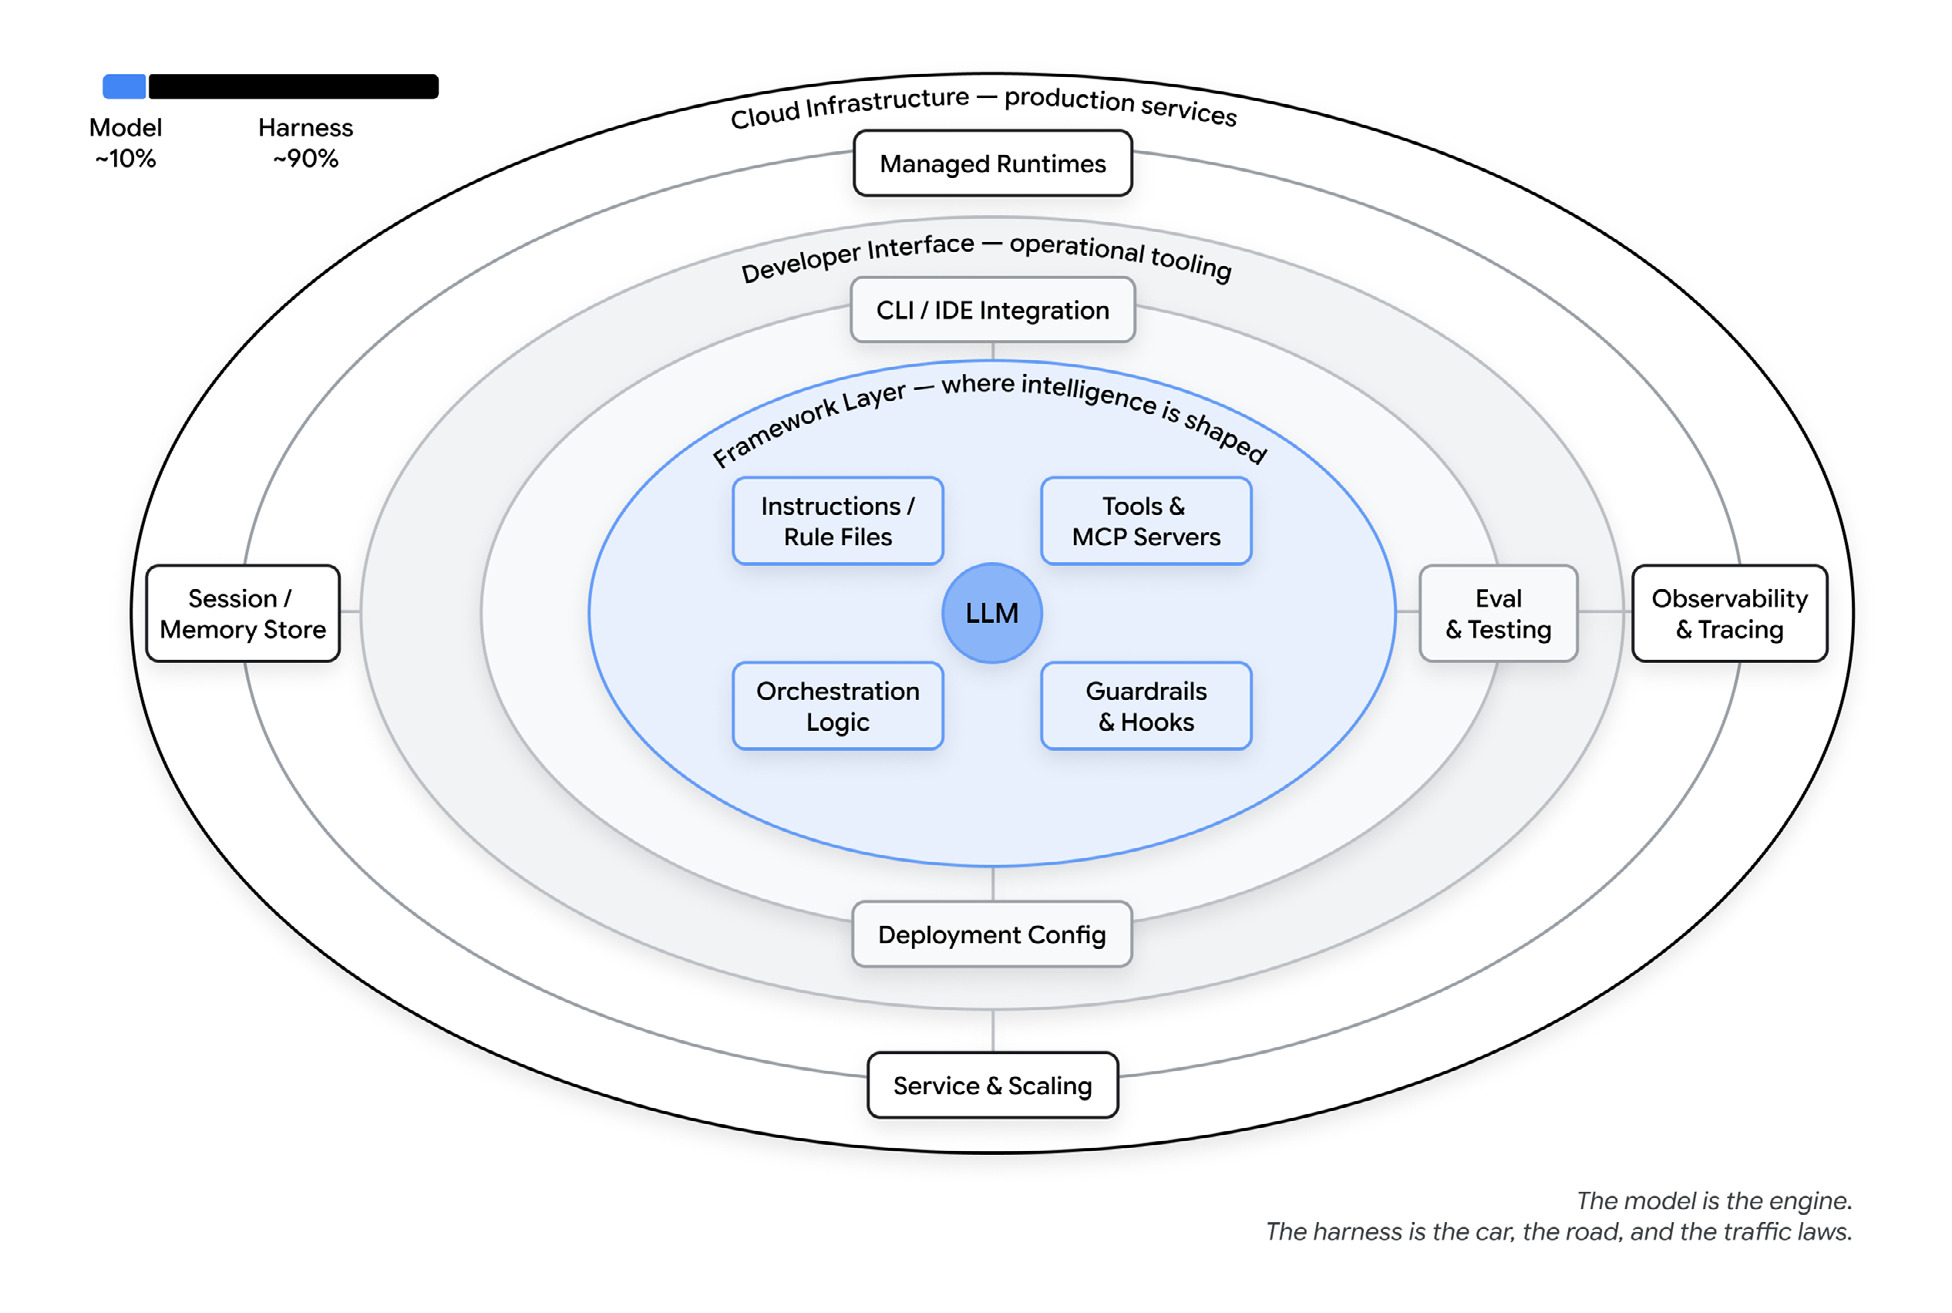
- Agent 的定义被简化成一句话:模型 + harness。模型只是一个输入,其余全是 harness——指令与规则文件、工具与 MCP 服务器、沙箱、编排逻辑、hooks、可观测性;粗略拆分是 10% 模型、90% harness。
- 两个硬数据支撑:Terminal Bench 2.0 上,一支团队只改 harness 就把编码 Agent 从 30 名开外推进前 5;LangChain 的实验只改系统提示、工具与中间件就让同一基准提升 13.7 分——都没动模型。
- 上下文工程是决定账单的旋钮:静态上下文每轮都加载(可靠但贵),动态上下文按需加载(只付任务需要的部分);Agent Skills 的渐进式披露让一个 Agent 携带几十个技能却只为一个付费。
- 验证是 vibe coding 与工程的分界线:测试覆盖确定性部分,eval 覆盖非确定性部分——输出评估问结果对不对,轨迹评估问路径是否合理;「把标准设在 eval,不是 demo」。
内容精讲
Google 发布的白皮书《The New SDLC With Vibe Coding》把 AI 对软件生命周期的影响系统化,最值得带走的是一个比例感:Agent 的模型部分只占约 10%,其余 90% 是 harness。模型是引擎,harness 是车、路和交规——指令与规则文件、工具与 MCP 服务器、运行的沙箱、生成子 Agent 并在模型间路由的编排逻辑、在设定点运行确定性代码的 hooks、告诉你它何时漂移的可观测性。10% 这个数字听起来夸张,直到你花一周调试其中一个。
**性能差距几乎全在 harness。** Terminal Bench 2.0 上,一支团队在模型不变的前提下,只改 harness 就把编码 Agent 从 30 名开外推进前 5;LangChain 的实验用固定模型只改系统提示、工具和中间件,同基准提升 13.7 分。结论直接:当 Agent 做了蠢事,先调试 harness——通常是缺工具、规则写太松、忘了护栏、或者上下文窗口里塞满了垃圾。大多数 Agent 失败是配置失败。这反而令人鼓舞:配置是今天就能修的部分,不用等更好的模型——而且模型迟早会在 harness 底下被换掉。
**上下文工程决定你的账单。** Agent 上下文分六类:指令、知识、记忆、示例、工具、护栏。真正影响账单的决策是「什么进静态、什么进动态」。静态上下文每轮都加载——系统指令、规则文件(AGENTS.md、CLAUDE.md、GEMINI.md)、全局记忆、核心护栏:可靠,但贵,因为每次调用都付钱。动态上下文按需加载——匹配任务时触发的技能、工具结果、从 RAG 拉取的文档:只付任务碰到的部分。平衡偏一个方向,烧 token 并淹没信号;偏另一个方向,Agent 忘掉保护它的规则。建议是把边界当真正的架构决策:在 PR 里评审、像代码一样版本化。让动态上下文规模化的是 Agent Skills 的渐进式披露:启动时看到一点元数据、任务匹配时加载完整指令、真需要时才拉重型参考材料——一个 Agent 携带几十个技能,却只为正在用的那个付费。
**验证:vibe coding 与工程的分界线。** 同一个 Agent 可以坐在从 vibe coding 到 agentic engineering 的任何位置,决定落点的是验证。测试覆盖确定性部分(这个输入、那个输出);eval 覆盖非确定性部分,又分两半:输出评估问最终结果是否正确,轨迹评估问到达结果的路径(工具调用、推理)是否扎实。两者都要——一个看起来对却跳过了检查的答案,比一个明显坏掉的更危险。给管理者的一句话:把标准设在 eval,不是 demo。demo 证明 Agent 能工作一次;带真实 rubric 的 eval 套件证明它可靠地工作。
**生命周期被不均匀压缩。** AI 压缩生命周期,但不均匀——不均匀正是全部故事。实现从数周掉到数小时;需求、架构与验证依然慢,因为它们是判断工作。于是规格质量成为瓶颈,验证移到了中间。需求不再是团队间传递的文档,而是同时产出规格与第一个原型的对话——Agent 从简报起草用户故事、暴露边界情况;同样的阶段,不同的瓶颈,不同的配比。对每个阶段的工程团队,这是一份「把力气花在哪」的地图:在实现上省下的时间,必须加倍投回规格与验证。
阅读价值
对软件工程管理者,10%/90% 与「验证是分界线」两个框架可以直接指导团队的 Agent 采用策略与验收标准;对 Agent 平台开发者,上下文工程的静态/动态划分与渐进式披露,是设计成本可控的多技能 Agent 的实操指南。
内容与图片版权归原作者所有 · 原文: https://addyosmani.com/blog/new-sdlc-vibe-coding/