 devgo.cn
最近几天,Jev 在开发者圈子里刷了屏。有人拿它做邮件分类,有人让它玩视频游戏,还有人试着用它做股票交易——一个模型横跨这么多完全不同的任务,而且效果据说都不错。但伴随热度而来的,是一大波“不过就是个分类器”的嗤笑。这两种声音我都看了不少,说实话,真相大概率在两者之间。
先搞清楚 Jev 到底是什么。它不是一个像 GPT 那样的生成式大模型,你给它一段文本,它不会接着往下写,而是输出一个类别标签——比如“这是垃圾邮件”或“这是工作邮件”。从技术架构上猜,它很可能是一个小型的 encoder 风格模型,类似 ModernBERT 这种。encoder 模型和 GPT 那类 decoder 模型的区别在于,decoder 擅长逐字生成内容,而 encoder 擅长把输入“压缩”成一组向量,再基于这组向量做判断。分类任务正是 encoder 的强项。
训练方式上,虽然没有公开细节,但业内猜测它用了类似“带校准奖励的强化学习”的方法。这个术语听起来唬人,拆开说就是:传统的分类模型训练时,只关心你分得对不对;而带校准奖励的训练,还会额外惩罚“模型很自信但其实是错的”这种情况。换句话说,它不仅要答对,还要知道自己什么时候没把握。这对分类器来说是个很关键的能力升级,因为很多实际场景里,模型瞎猜一个答案比承认“我不确定”危害大得多。
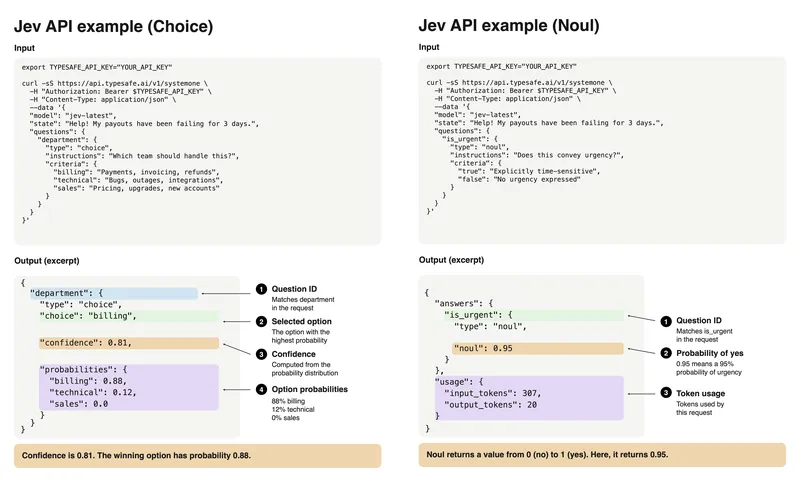
是 Jev API 的实际调用示例,可以看到它处理 Choice 和 Noul 两类任务时的请求输入和标注输出。
其实,用 encoder 模型做分类这件事本身毫无新意。过去十年里,我和很多人一样,一直在训练这类模型处理各种分类任务。但问题在于,这些模型通常都是“专用”的——你为垃圾邮件训练一个,为情感分析再训练一个,每个模型都只能干一件事,换个领域就得重新标注数据、重新训练。这是分类器一直以来的天花板:泛化能力差。
展示的正是这种传统分类器的局限性——它们往往被限定在特定任务里,换个场景就失灵。
Jev 真正让人眼前一亮的地方,恰恰是它打破了这层天花板。同一个模型,既能筛邮件,又能打游戏,还能分析股票,这种跨领域的泛化能力在分类器里极其罕见。为什么能做到?我的判断是,秘密大概率不在训练算法,而在数据。算法框架可能还是那套老东西,但喂进去的数据质量和组织方式,可能发生了质变。再加上它外面套了一层设计得很舒服的 API,让开发者能轻松调用,这体验上的加分项也不容忽视。
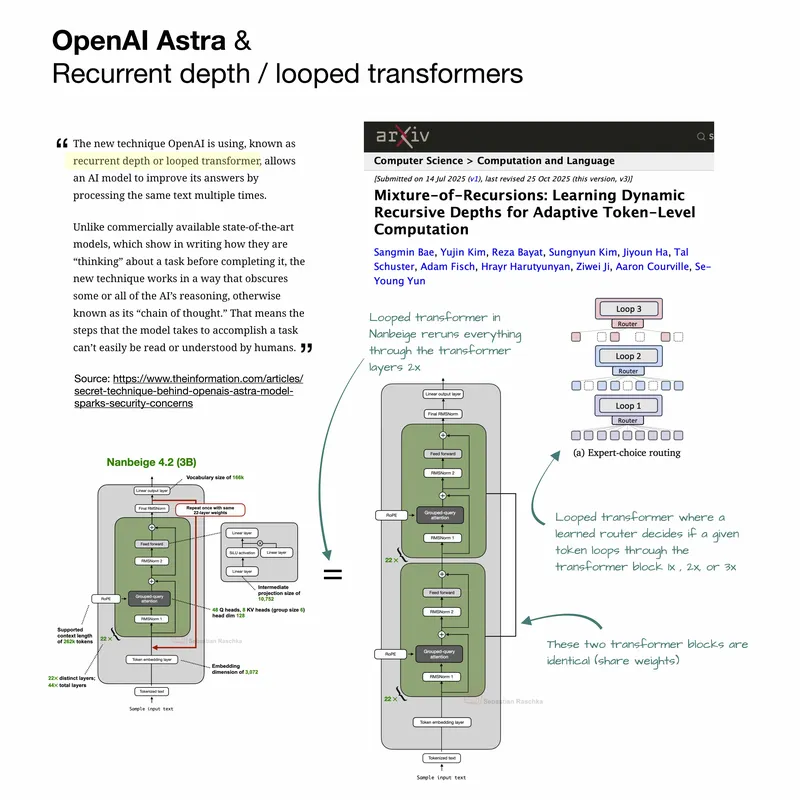
对应的是把强化学习应用到非自回归、encoder 风格模型上的尝试——这并非 Jev 首创,之前就有人做过类似实验。
把强化学习用到非自回归模型上,Jev 不是第一个。但“第一个做”和“做得好、做得能落地”是两码事。历史上这种例子太多了:Stable Diffusion 的核心架构来自一篇已有的研究论文,但真正让它火遍全球的是后续在数据和组织上的工程化打磨;2022 年 ChatGPT 的爆火,本质上是 InstructGPT 的改进版,算法没变,变的是数据策略。Jev 大概率也是同样的剧本——算法是已知的,数据是制胜点。
这件事对普通开发者的启发很直接。如果你手里有分类需求,比如内容审核、工单自动分派、日志异常识别,过去你可能要为一个场景专门训练一个模型,费时费力。Jev 这种通用分类器的思路告诉你,一个训练得当的 encoder 模型加上精心构造的数据,完全可能覆盖多个场景。当然,也别高兴太早——它目前能玩转的领域到底有多广、边界在哪里,还需要更多真实场景的验证。而且既然训练细节没公开,想自己复现一个同样水平的模型,短期内并不现实。但至少,它给“分类器做不大”这个固有印象,提供了一个有力的反例。
内容与图片版权归原作者所有 · 原文: https://sebastianraschka.com/blog/2026/jev-classification-generalization.html