 devgo.cn
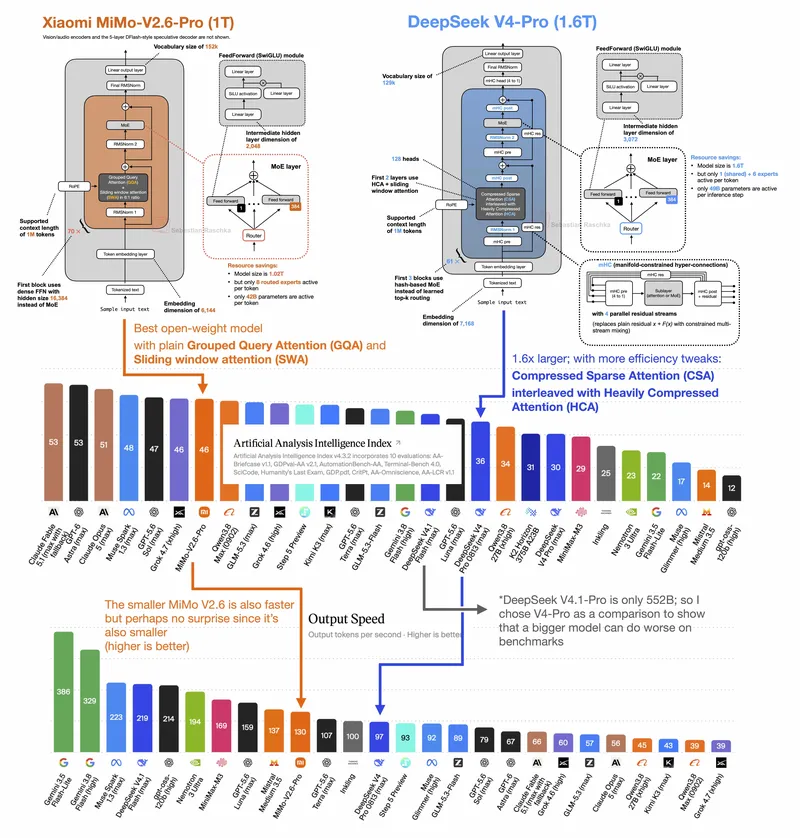
如果你最近在关注开源大模型的排行榜,可能会注意到一个有点反常识的结果:小米的 MiMo-V2.6 Pro 在开放权重模型的加权平均基准上拿下了第一,但它的架构设计却朴素得让人意外——经典的 GQA(分组查询注意力,一种让多个查询头共享键值头、从而减少推理内存占用的注意力变体)加上 SWA(滑动窗口注意力,只让每个 token 关注它附近固定窗口内的 token,用来控制计算量),而滑动窗口的大小只有 128 个 token。这个窗口尺寸在今天的语境下小得近乎苛刻,对比一下,很多主流模型动辄用 4K、8K 甚至更长的上下文窗口。
这件事之所以值得停下来想一想,是因为它直接戳破了一个被过度神化的叙事:过去两年,大家总以为模型能力的跃升主要靠注意力机制的创新——什么稀疏注意力、线性注意力、多查询注意力,各种花活层出不穷。但 MiMo-V2.6 Pro 用结果告诉我们,至少在开放权重这个赛道上,那些花哨的注意力变体本质上只是效率优化,真正拉开差距的,是数据和后训练(post-training,即模型预训练完成之后,通过指令微调、人类反馈强化学习等阶段进一步打磨能力的环节)的配方。
那小米到底在数据和后训练上做了什么?技术报告里信息量不小,但最值得拎出来的是三个变化。
第一个变化是 Agent 任务的比重明显增加了。所谓 Agent 任务,就是让模型去调用工具、写代码、执行多步操作来完成一个目标,而不是简单地回答问题。更关键的是,他们不再只在一个固定的测试环境里训练,而是跨了多个不同的 harness(测试框架,也就是用来评估模型在真实任务上表现的那套运行环境)来训练。效果是实打实的:在保留的、没见过的 harness 上,DeepSWE pass@1 的准确率(即模型一次生成就能通过软件工程任务测试的比例)从大约 50% 提升到了 66%。这个提升幅度相当可观,说明模型学到的不是针对某个特定测试集的套路,而是更通用的 Agent 能力。
第二个变化是奖励信号的质量。之前很多强化学习训练用的是简单的正确性验证器——比如代码跑通了就给正奖励,跑不通就给负奖励。小米这次换成了一个 agentic grader(智能体评分器,一个会像 Agent 一样去执行任务、观察中间过程的评判模型),它不光看最终结果对不对,还会检查执行轨迹——也就是模型在完成任务过程中的每一步操作和中间输出。这相当于从只看卷面分,变成了既看答案也看解题过程,能捕捉到很多结果正确但过程有问题的失败模式,给强化学习提供了更细粒度的反馈信号。
第三个变化是强化学习的规模。他们用了 1,568 个提示词,每个提示词做 16 次 rollout(采样生成,即对同一个问题让模型生成多个不同的回答轨迹),总共产生 25,088 条轨迹,每次更新要消耗 27 到 37 亿个训练 token。这个规模在开源模型里属于相当激进的,虽然报告里没提上一代模型用了多少,但可以推测这个量级的提升是效果跃升的重要推手。
最让我意外的是,这三个改进没有一个是架构层面的,全是数据和训练策略的工程细节。这其实给整个行业提了个醒:当大家都在卷注意力机制、卷 MoE(混合专家,把模型拆成多个专家子网络、每次只激活其中一部分来降低计算成本的架构)的时候,可能忽略了一个更朴素的事实——模型的能力上限,很大程度上是被训练数据的质量和训练策略的精细度决定的。
这个思路对普通开发者有什么直接启发?如果你在做自己的模型微调或者强化学习训练,可以立刻借鉴这三点:第一,如果你的任务涉及多步推理或工具调用,别只在一个固定测试集上训练,尽量让训练数据覆盖更多样的环境,模型才能学到真正通用的能力;第二,检查一下你的奖励函数,如果只用最终结果的正确性做判断,试试能不能引入过程信号——哪怕是一个简单的中间步骤检查,都可能让训练稳定性和最终效果上一个台阶;第三,在算力允许的情况下,把强化学习的采样规模往上提,很多时候效果上不去不是算法不对,而是探索得不够。
当然,也要注意一个坑:这种大规模强化学习训练的成本不是每个团队都能承受的,25,088 条轨迹、每次更新几十亿 token,对算力有硬性要求。但好在思路是可以降级复用的——即使你把规模缩小十倍,用 agentic grader 替换简单验证器、跨环境训练这两条经验,依然能带来可感知的提升。小米这份报告的价值就在于,它用开源模型第一的成绩,把"数据和后训练比架构创新更重要"这个观点变成了一个可验证的事实。
内容与图片版权归原作者所有 · 原文: https://sebastianraschka.com/blog/2026/mimo-v2-6-pro-architecture-training-notes.html