 devgo.cn
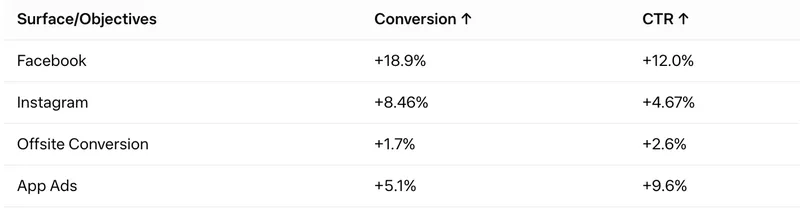
如果你的业务依赖推荐系统,一定遇到过这个怪圈:模型越做越复杂,效果提升却越来越慢;想上更大的模型,训练成本、线上延迟双双爆炸。Meta 的广告推荐系统 GEM 给出了一个相当激进的答案——直接放弃传统推荐系统的设计思路,把广告推荐整个改造成 LLM(大语言模型,就是 GPT 这类基于 Transformer 的模型)的架构,然后像训练前沿大模型一样去训练它。结果是什么?在过去一年里,GEM 为 Meta 全系广告带来了 18.9% 的转化提升和 12% 的广告点击率提升,Facebook、Instagram、站外转化分别额外贡献了 5.8%、4.1%、1.6% 的转化增量。
这背后不只是堆算力,而是一整套和硬件深度协同的工程改造。Meta 去年发布了 GEM 的第一代,当时已经号称是行业最大的推荐系统基础模型。但这一代 GEM 还是按传统思路,Facebook、Instagram、Reels 各自为政,每个域有自己独立的预测系统。2026 这一代(原文口径,指当前最新一代)的做法彻底变了:把所有广告平台的信号放进一个统一的中心基础模型,用一套参数同时预测点击和转化,覆盖从品牌曝光到站外转化的全漏斗目标。
一个反常识的点:推荐系统也能有缩放定律
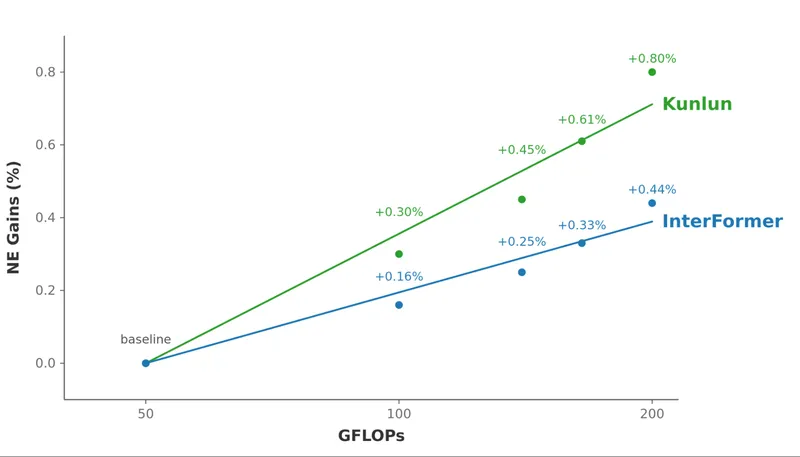
大模型领域有个著名的缩放定律(scaling law):模型越大、数据越多、算力越强,效果就按可预测的曲线往上涨。但推荐系统以前并不吃这一套——它的特征极其异构,用户行为分布又一直在变,单纯加参数往往不灵。GEM 的团队这次故意把架构往 LLM 的方向靠,搞了一个叫 Kunlun 的新架构(Kunlun 是 GEM 内部的新一代推荐模型架构,和上一个版本 Interformer 对应),并且和最新 GPU 硬件联合设计。结果他们观察到:在最大的预训练规模下,模型复杂度相比上一代翻了 2.5 倍,却出现了类似 LLM 的缩放效应——容量和上下文长度增加,排序质量出现了涌现式的提升,直接转化成了业务指标。这一点很有启发性:如果特征工程和序列建模能做得足够像语言建模,推荐系统也许真的能搭上大模型那趟快车。
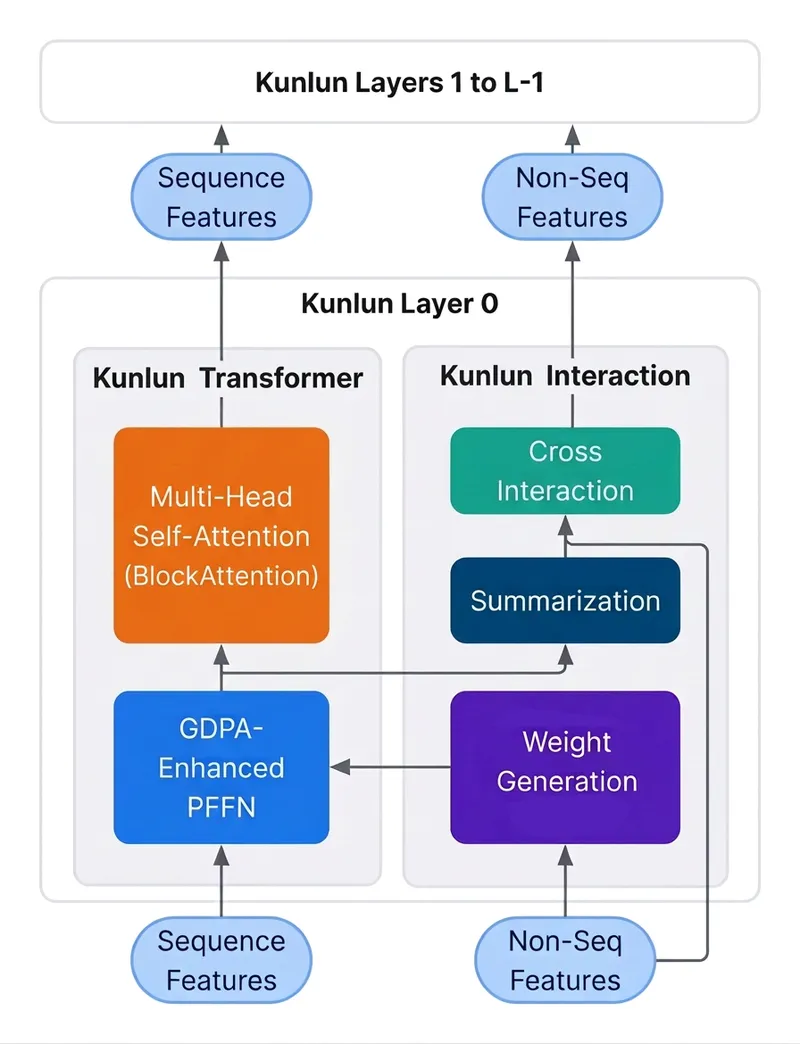
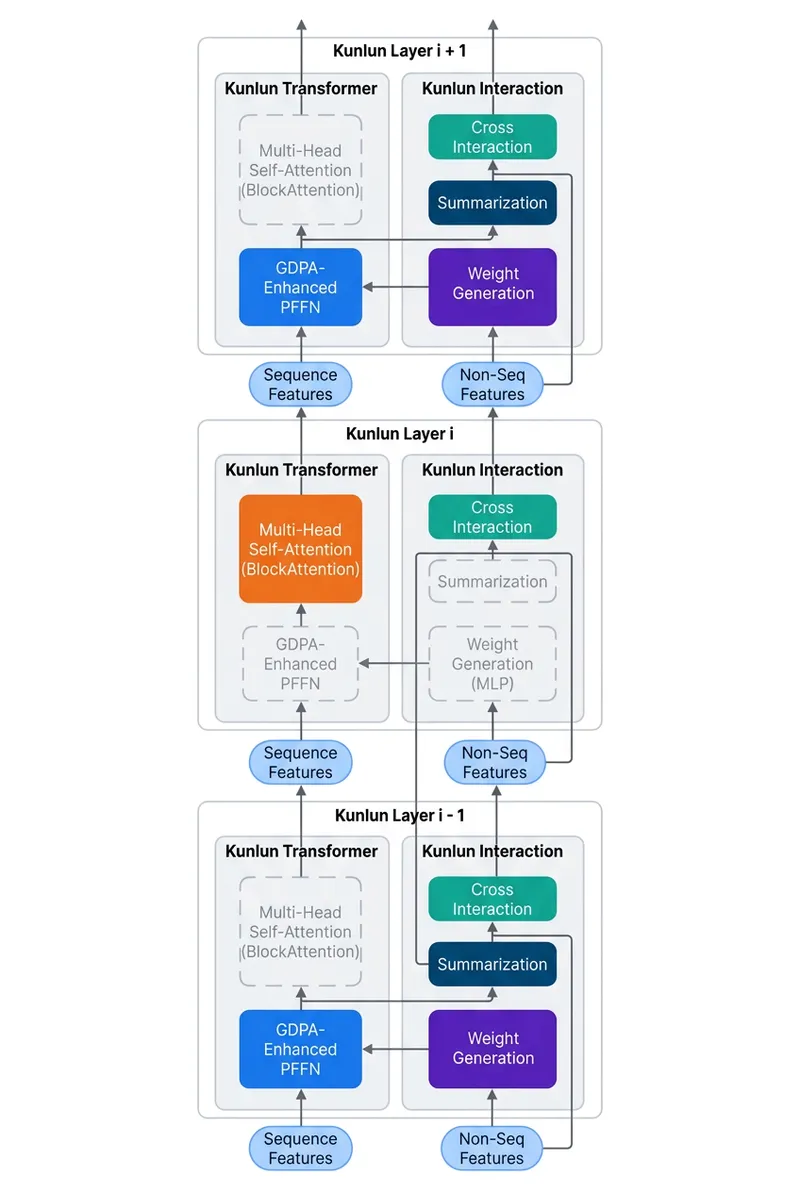
Kunlun 架构本身有三个核心设计。第一是统一架构框架:每一层同时包含注意力(attention,就是大模型里那种让序列中每个位置互相关注的机制)、摘要组件(从用户行为序列里提炼关键偏好的模块)、以及交叉交互(把序列信息和非序列信息比如用户画像、广告内容特征结合起来)。其中交叉交互被扩展成了 MoE 风格(MoE 即混合专家模型,把一个大网络拆成多个小专家网络,每次只激活一部分,降低计算成本),这样可以在大规模下建模复杂的用户-广告交互。第二是和硬件深协同:他们用块对齐稀疏注意力代替了全量自注意力,把序列长度的计算复杂度从二次方降到了和窗口大小成线性关系,同时专门定制了 GPU kernel 和低精度计算。第三是高效序列扩展:通过离线的序列基础设施去处理超长的用户历史行为,让模型能'记住'更久以前的交互。
线上服务不可能直接跑这么大的模型,怎么办?
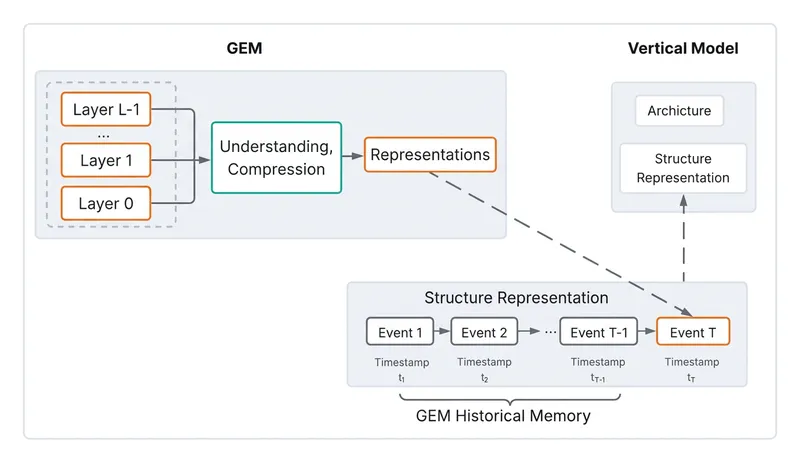
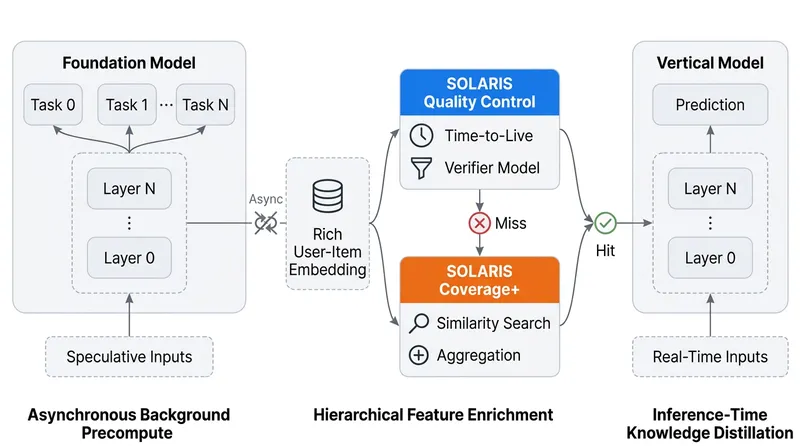
一个 2.5 倍复杂度、在数千张 GPU 上训练的巨型模型,不可能在用户请求的实时链路上直接推理——延迟会高到无法接受。Meta 的解法是一条典型的'蒸馏+预计算'链条。模型内部有一个叫 LoopFM 的结构化表示(可以理解成把用户历史行为序列压成一组紧凑的向量,作为中间状态导出),通过它把 GEM 的'内功'迁移到面向用户的小模型上。这项后训练技术相比上一版,在完全不多花计算和延迟的前提下,把知识蒸馏(让小模型学习大模型的输出分布,从而模仿大模型行为的常用压缩手段)的智能迁移效率翻了一倍。同时他们还引入了一个叫 Solaris 的弹性预计算机制,提前把上游大模型能算的分数都算好缓存起来,线上直接查表。
这里最值得注意的不是某个单一技术,而是'分工'的思路:超大模型负责从全平台数据里学出通用的用户理解,小模型只负责线上快速响应;中间层用结构化表示和预计算来传导。这套思路在广告推荐之外同样适用——任何有大模型但实时性要求高的场景,比如搜索排序、内容推送,都可以借鉴'离线的重模型 + 在线的轻模型 + 预计算缓存'的三角结构。
跨域统一学习:3.6 亿日活用户的数据怎么混在一起训?
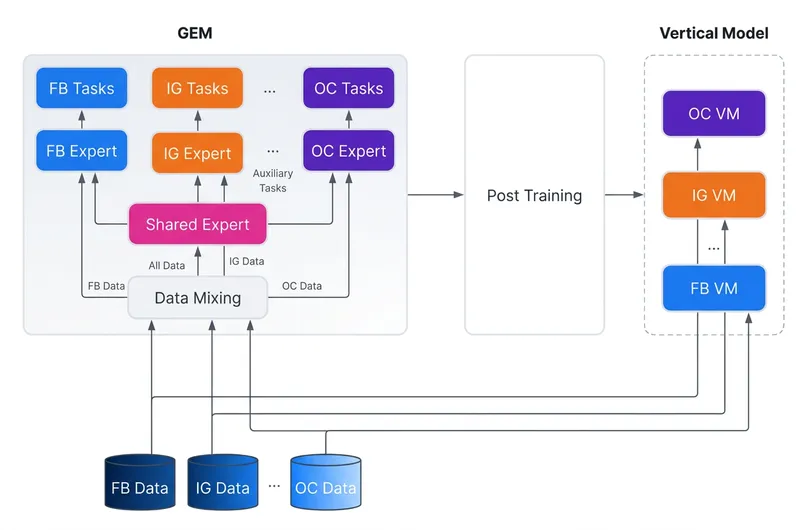
Meta 每天有 36 亿人至少使用其一款应用,几十个广告面(Feed、Reels、Stories……)和几十种广告目标(站外转化、App 安装、品牌曝光……)。以前每个面各训一套模型,数据稀疏的任务(比如冷门行业的转化)效果总是不够好。GEM 用一个中心模型同时预测所有面的点击和转化,让在点击这类数据富集任务上学到的通用表示,迁移到数据稀疏的转化任务上。这背后的训练配方也很有意思:他们提了一个'免费数据混合'(cost-free data mixing)的方法,不增加额外训练成本就能把不同来源的数据混合在一起,再加上一个'领域专家框架'(domain expert framework,相当于在统一模型内部给不同业务域各留一组可独立优化的参数),才让这么异构的大规模学习变得可控。
从工程角度看,这其实是用一个大模型的参数空间去隐式地做迁移学习,省掉了以前要为每个细分目标单独调一个模型的大量工作。如果你在做一个多业务线的平台,这个思路可以直接借鉴:与其给每条业务线单独建模型,不如先做一个共享底座,再用领域专家结构去适配差异。
训练效率翻倍:从 LLM 血统里偷师
推荐工作负载和 LLM 有个本质差别:推荐的特征极度稀疏、数据分布极不稳定,GPU 利用率很难提上去。Meta 这次把总训练 FLOPs(FLOPs 就是浮点运算次数,衡量计算量的单位)扩大了 4 倍,同时端到端训练效率翻倍到 20-25% 的模型 FLOPS 利用率(MFU,就是实际用于模型计算的有效算力占GPU理论峰值算力的比例)。这个数字在推荐系统领域属于相当高的水平,因为 LLM 训练通常也只能做到 30-50% 左右(参考行业惯例),而推荐系统能做到 20% 以上已经很难得。他们做的三件事:定制低精度 kernel(kernel 就是 GPU 上执行特定计算的核心程序,低精度指的是用更少比特数表示数值来换取速度)、新的 5D 并行策略(5D 并行指在数据、模型、张量、序列、流水线五个维度同时切分计算任务)、以及把模型架构和训练集群基础设施一起优化。这提醒我们:大模型的工程能力是可以复用到推荐等其他领域的,关键是意识到推荐数据的特点去定制方案,而不是直接抄 LLM 的并行方案。
对我们有什么实际启发?
GEM 这套东西虽然跑在 Meta 的广告场景,但拆解出来的方法,对做推荐、搜索、甚至任何涉及'大规模个性化排序'的团队都有参考价值。第一,如果你发现自己的模型加了参数效果就停滞,可以试试把序列特征建模得像语言模型一样——引入注意力、长上下文、MoE 交叉交互,而不是继续堆传统的特征工程。第二,不要指望一个巨型模型能实时服务,用蒸馏+预计算把重逻辑下沉到离线,是必然选择。第三,多业务线统一建模不是靠'把数据拼一起训'那么简单,领域专家框架和免费数据混合是让异构训练可行的关键细节。
要警惕的坑也很明确:这套架构的收益建立在超大算力和超大规模数据上,中小团队照搬架构大概率只会得到高昂成本而非涌现效果。缩放定律要在一个临界规模之后才会出现,所以你可以先在小规模上验证效果,再决定要不要砸钱。另外,序列长度的线性化计算(块稀疏注意力)和 GPU kernel 的深协同,都是和具体硬件绑定的,换一代硬件可能就要重新调优,别指望一次性投入一劳永逸。
内容与图片版权归原作者所有 · 原文: https://engineering.fb.com/2026/10/13/ml-applications/generative-ads-model-gem-scaling-frontier-ads-ai/