 devgo.cn
如果你所在的公司同时跑着十几个 AI 推理模型——比如多个开源大模型、几个微调版本、再加一个实时语音识别——你大概率遇到过类似的问题:每个模型一个调用地址,客户端要记住一堆 URL,安全策略分散在各地,想统一加个限流或审计就得挨个改。更头疼的是,模型背后的基础设施五花八门:有的跑在 Kubernetes 上,有的用 Serverless,还有的干脆在本地机房。这种混乱状态下,每次上线新模型都是一场小型灾难。
Google Cloud 最近发了两篇参考架构,专门解决这个网络层的难题。核心思路很简单:把模型调用收敛到一个稳定的入口,这个入口同时充当策略控制点,所有请求都从这里进,统一做认证、限流、内容安全检测,再按模型名字路由到正确的后端。文章给出了两套设计,一套只针对 GKE(Google Kubernetes Engine,谷歌托管的 Kubernetes 服务),另一套覆盖所有后端类型,包括 Cloud Run、Agent Platform、本地机房甚至外部云。
先说两套架构的共性部分。它们都依赖三个关键组件:
- **Private Service Connect 推理端点**:把入口锚定在你自己 VPC(虚拟私有云,一个隔离的网络环境)内部。客户端访问的是一个私有 IP,流量全程不出内网,既安全又省了公网暴露的麻烦。
- **Apigee API 管理(可选)**:在请求到达计算资源之前,用它做客户端身份验证、速率限制和配额控制。相当于一个 API 网关,把控制逻辑集中起来。
- **Model Armor**:一个内联的 AI 安全检查点,专门拦截提示注入(恶意构造输入让模型输出危险内容)和敏感数据泄露,对输入和输出都做筛查。
这三件套组成了标准的“前门 + 安检”模式。接下来看两套架构各自的差异。
**GKE 专用设计**
如果你的推理模型全部部署在 GKE 里,这套架构可以借助 GKE 原生的能力。最核心的组件是 **GKE Inference Gateway**——它本质上是一个内部的负载均衡器(gke-l7-rilb),但专门为推理场景做了优化。它不只是转发流量,还会解析请求体里的模型参数,根据 HTTPRoute 规则(HTTP 路由规则,决定请求该送往哪个后端)把查询导向对应的模型。
请求流程是这样的:客户端在 VPC 内发起 OpenAI 兼容的 API 调用(OpenAI 兼容格式是目前事实上的标准,大多数推理服务器都支持),流量走到私有端点,由网关接收。网关先读取请求体里的目标模型名,把它加到 HTTP header 上。如果启用了 Apigee,就先做凭证和配额校验;Model Armor 则对 prompt 做安全过滤。然后网关根据 HTTPRoute 映射找到对应的推理池(一组相同模型的副本),结合实时负载数据(来自 Prometheus,一个开源的监控系统),把请求路由到当前负载最低的 GPU/TPU 副本。最后,模型的输出 token 在返回前还要过一次 Model Armor,确保没有泄露敏感信息。
整个链路最妙的地方在于,网关相当于一个智能路由器,它知道每个模型的副本状态和系统负载,能自动做负载均衡和扩缩容(推理池可以配置动态自动扩展)。这让“模型调用”变得像打一个内部 API 一样简单。
展示了这套设计的全局架构。
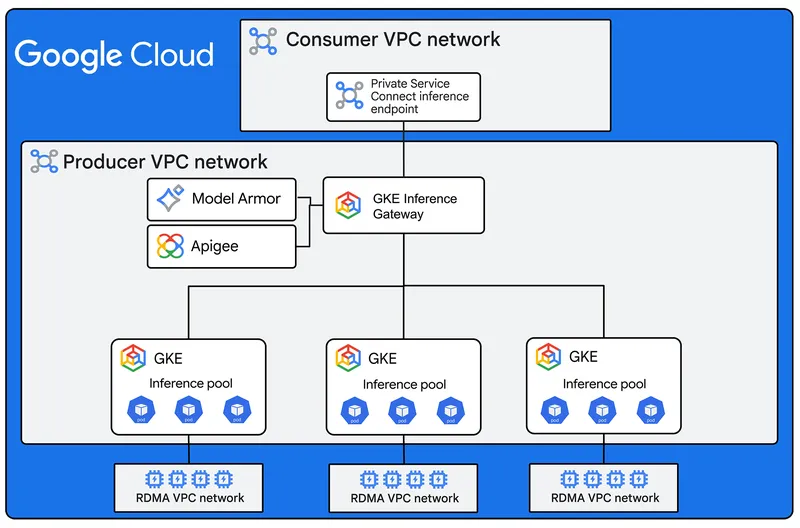
是 GKE 模式的示意图。
是流量走向的示例。
是网关根据 Prometheus 实时数据选路的部分。
**覆盖所有后端的通用设计**
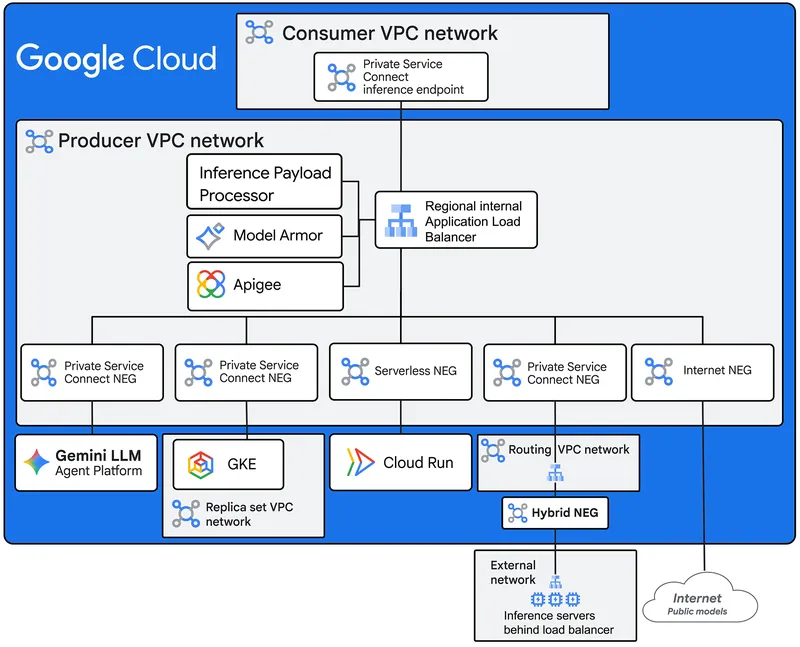
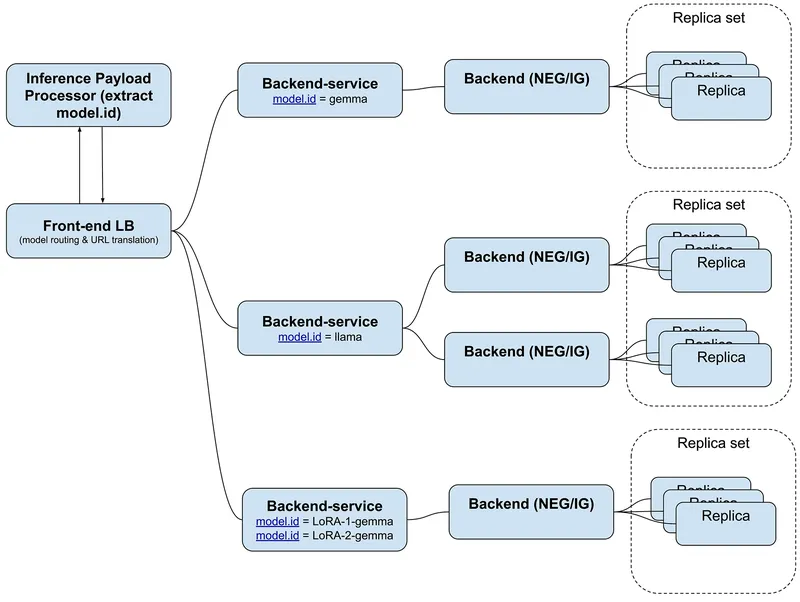
如果模型不止跑在 GKE,还有 Cloud Run、Agent Platform(谷歌的智能代理部署平台)、本地机房甚至其他云,GKE 专用方案就不够了。这时需要一个通用的入口——**区域内部 Application Load Balancer**(一个位于 VPC 内部的第 7 层反向代理,可以理解为一个更灵活的负载均衡器)。它负责路由逻辑、SSL 终止(解密 HTTPS 请求)和扩展调用。但由于它不像 GKE Inference Gateway 那样天然能解析请求体,需要额外的组件来取模型名:一个轻量级的 Cloud Run 服务作为 **Inference Payload Processor**,它检查 OpenAI 请求的 JSON body,提取目标模型字段,然后写入一个自定义 header(X-Gateway-Model-Name),驱动 URL map 的路由决策。
之后,负载均衡器的 URL map 根据这个 header,把请求转发到匹配的后端 **NEG(Network Endpoint Group,网络端点组,一种抽象的后端资源集合)**。NEG 的好处是高度灵活,可以把流量导到任意类型的后端——GKE、Cloud Run、本地或外部云。整个流程:私有入口进入 → Cloud Run 提取模型名 → Apigee 和 Model Armor 做策略与安全 → NEG 路由 → 后端执行推理 → 输出再次经过 Model Armor → 从原路私有返回。
这套通用方案的核心价值在于,它把“模型路由”从各后端自己的逻辑中抽离出来,变成了负载均衡层的职责。任何新后端,只要挂上一个 NEG 并配置好 URL map,就能接入统一入口,不需要改造原本的推理服务。
是这套通用架构的示意图。
展示了私有入口的阶段。
是相关文档的指引。
**对我们有什么启发**
这两套架构本质上是在回答一个问题:当模型数量和后端类型爆炸时,如何让调用体验依然像打单个 API 一样简单,同时还能集中控制安全与治理。我最大的感触是,这不仅是给 Google Cloud 用户的指引,更是一种通用的设计模式——无论你用的是哪家云,都可以借鉴“入口收敛 + 请求体识别 + 按模型路由 + 统一安全检查”的思路。如果你所在团队正在构建内部推理平台,可以思考:是否有一个专门的网关来解析模型名?是否把所有策略都前置到入口处?如果后端是异构的,是否用带 header 的负载均衡器来统一路由?
要注意的坑有两类:一是扩展机制,比如 Service Extensions 需要额外开发,得评估成本;二是模型路由的实时负载均衡需要可靠的指标源,Prometheus 这类监控系统必须稳定。另外,安全过滤(Model Armor)虽然强大,但会增加延迟,如果对响应时间极度敏感,可能需要权衡是否在输入输出都启用。总体而言,这套架构提供的是一个可落地的参考,不是纸上谈兵,值得深入研究。
内容与图片版权归原作者所有 · 原文: https://cloud.google.com/blog/topics/developers-practitioners/networking-for-ai-inference-model-serving-gke-only-and-for-all-other-backends/