 devgo.cn
你有没有想过,当一个 AI Agent 开始频繁查数时,最容易被压垮的往往不是计算引擎,而是那个看起来不起眼的元数据目录?在湖仓架构里,Apache Iceberg 已经成为跨引擎共享数据的标准格式,而配套的 Iceberg REST Catalog 则负责维护表指针、处理原子提交、充当表位置的唯一事实源。传统方案用单体关系数据库存元数据,但随着查询规模涨到 Agent 级——成千上万个并发小查询不断打过来——数据库的 CPU、内存、连接数很快就会见顶。Google Cloud 最近发布了基于 Spanner 的 Lakehouse 运行时目录(GA),专门解决这个瓶颈。这篇文章拆解了它怎么做到高可用、强一致、无限水平扩展,以及一个迁移案例:Etsy 把目录迁上去后,管道查询提速 60%。
**为什么目录成了瓶颈?**
先看目录要扛什么活。Iceberg 用乐观并发控制(OCC,即提交时检查版本是否冲突)来保证 ACID 事务,所以目录必须实现一个绝对可靠的原子比较并交换(CAS,把旧指针换成新指针的操作)——任何两次写同时发生时,只有一次能赢。目录不可用,所有查询立刻失败,所以它成了 Tier-1 关键服务。更麻烦的是底层数据库的选择:传统纵向扩展的 SQL 数据库提供事务,但高并发读写下会撞上垂直天花板,除非手动分片——那是巨大的运维负担;横向扩展的 NoSQL 系统又往往只有最终一致性,或不够企业级。
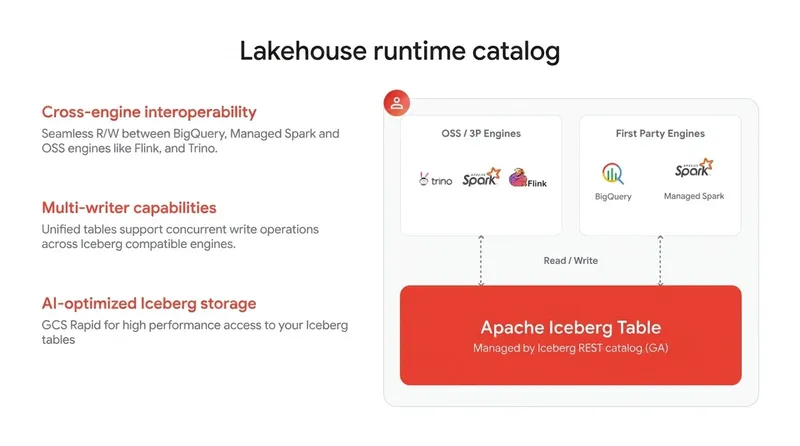
另外,目录还得管治理和安全:OAuth2 令牌交换、IAM 联邦、命名空间和表级访问控制,以及生成短期存储凭证(让引擎不用持有底层对象存储的全局密钥)。单靠目录本身也不够,你还要自己搭配套管道做压缩、快照过期、清单重写和孤儿文件清理。
**方案:全托管 + 开放 API 的运行时目录**
Google Cloud 的做法是直接实现 Iceberg REST Catalog 规范,把它做成一个无服务器、高可用的统一元数据注册中心。好处很直接:表一旦注册,BigQuery、托管 Spark、开源引擎都能立刻发现并查询,不需要数据拷贝,表定义直接指向底层对象存储。
跨云联邦也值得一提:它能从 Databricks Unity、Snowflake Horizon、AWS Glue 访问数据,支持凭证下发和 OIDC 令牌交换,相当于把 Google AI 的能力直接拉到 AWS 和 Azure 的数据上。安全方面,你可以选凭证下发或终端用户凭证,引擎不需要直接触碰对象存储文件。AI 上下文治理直接集成 Knowledge Catalog 和 Cloud IAM,表级安全策略在所有引擎间一致生效。
**底层核心:Spanner 的横向扩展 + 强一致**
最让我意外的是,这一切不是靠什么神秘黑科技,而是因为底层是 Spanner。Spanner 把传统关系型 SQL 语义和多表 ACID 事务,跟 NoSQL 的横向扩展融合在一起。它不需要手动分片,计算和存储独立透明地扩展:动态监控数据量和查询负载,把数据范围自动拆分并重分布,计算节点按 CPU 利用率动态伸缩,还能自动检测热点分区并把重负载移走。区域配置提供最高 99.99% 可用性。这就是为什么这个目录敢说能支撑 Agent 时代的重复小查询——目录的元数据规模和数据规模一起涨,但不需要你半夜起来调参。
**对你的启发**
如果你正在搭自己的湖仓,且计算引擎不止一家(比如 Spark 和 Trino 混用),别再用一个单点 MySQL 当 Iceberg 目录。要么直接用这种托管目录,要么学它的核心思路:把目录和引擎彻底解耦,用支持强一致 + 水平扩展的分布式数据库(Spanner、TiDB、CockroachDB 这类)来承载元数据,并用标准 REST 协议对外暴露。另外注意几个坑:凭证下发机制必须设计好,别把长期密钥直接发给引擎;跨云联邦虽好,但网络延迟和合规要提前规划;表维护管道(压缩、快照过期)不能省,目录不负责优化数据文件。对于想把手头 Spark 作业提速的场景,先查一下元数据层是不是已经在拖后腿——迁移目录的成本可能远低于重写数据管道。
内容与图片版权归原作者所有 · 原文: https://cloud.google.com/blog/products/data-analytics/lakehouse-runtime-catalog-powered-by-spanner/