 devgo.cn
每天早上,库存经理都要面对同一个问题:今天该进多少货?答案取决于几十个变量——销售历史、即将到来的促销、价格变动、星期几的季节性、供应商的交货周期。而判断错误的成本是极不对称的:多进了,资金压在慢销库存上;少进了,丢掉收入、伤害客户信任,还得手忙脚乱地紧急补货。
传统时序预测方法(如ARIMA、Holt-Winters、季节性分解)要求对每个SKU单独建模。一个有一万个SKU的零售商,就得训练、验证、维护一万个独立模型,每个都要单独调参、安排重训计划,新品还有冷启动问题。运营负担随目录规模线性增长,工程团队把时间都花在管基础设施上,而不是改善预测质量。梯度提升和深度学习(LightGBM、DeepAR、Temporal Fusion Transformer)能提升准确率,但进一步加重了操作复杂度:特征工程管道、训练任务、模型注册表、A/B测试设施。对很多组织来说,从"我们想要更好的预测"到"预测在生产环境跑起来",往往要花整整一个季度或更久。
即便有了可靠的预测,把需求信号转成采购订单还需要应用业务规则:安全库存缓冲、最低起订量、预算约束、促销提升调整。这些规则通常藏在电子表格或机构知识里,不同采购员执行得不一致,规模化后几乎无法审计或解释。
这篇文章讲的是怎么把两个互补能力组合起来,同时解决这两个问题:
- **Amazon Chronos2**:一个时序基础模型,做零样本预测,不需要针对每个产品单独训练,直接返回概率性需求预测。
- **Strands Agents SDK + Amazon Bedrock AgentCore** 的多智能体编排:一个由四个LLM智能体组成的系统,协调确定性工具,把原始预测转成经过验证的采购订单,全程可审计。
结果是一条端到端的库存自动化流水线:添加新品零模型训练,新增一条业务规则只改一个工具,每个决策都可审计、可观测、可从失败中恢复。内部测试中,覆盖50个SKU、4周预测区间,中位加权绝对百分比误差(WAPE,衡量预测误差占实际需求的百分比)为12.3%(P50预测对比实际值);单个SKU的接入时间从2-3周模型训练缩到不到5分钟的CSV上传;月度推理成本从约$1,091(常驻GPU)降到约$15(Serverless),降幅98%。端到端流水线延迟平均每SKU 8秒(不含冷启动)。
方案总览
系统分三个逻辑层:
- **数据层**:Amazon S3作为唯一的事实来源。每个产品一个CSV文件,编码历史销售和未来协变量值。业务规则(交货周期、安全库存、仓库容量、最低起订量)放在单独的JSON配置里。新增产品只上传这两个文件,不改任何代码。
- **推理层**:Amazon SageMaker Serverless Inference托管Chronos2端点,做零样本时序预测。这是流水线里唯一的外部模型推理调用——LLM推理在编排层内通过Amazon Bedrock完成。
- **编排层**:四个LLM智能体——Supervisor(监督)、Preprocessing(预处理)、Forecasting(预测)、Reporting(报告)——用Strands Agents SDK构建,部署在Amazon Bedrock AgentCore上。每个智能体用Amazon Bedrock上的Claude做推理,调用确定性工具执行计算工作。
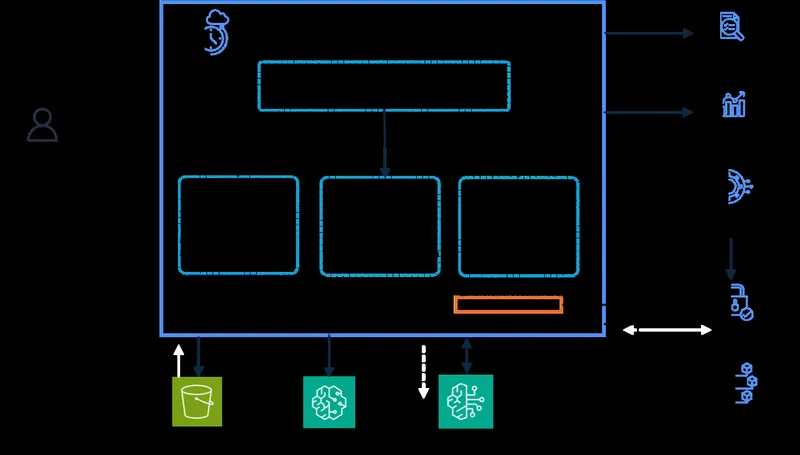
Amazon Bedrock AgentCore编排四个LLM智能体(Strands Agents SDK),这些智能体调用确定性工具访问Amazon S3和Amazon SageMaker Serverless Inference。
Amazon Bedrock AgentCore是一个全托管平台,用任何框架或模型大规模构建、部署、优化智能体。编排层跑在AgentCore上,它提供六个子服务:Runtime(运行时)、Gateway(网关)、Policy(策略)、Memory(记忆)、Observability(可观测性)、Evaluations(评估)。这个系统六个都用,但每个只用在特定单一用途上。架构详解部分会把每个服务对应到本设计里解决的生产场景——包括为什么Gateway的暴露面故意做得很小(八个工具只暴露一个)。
为什么选Chronos2:零样本、协变量、what-if
Chronos2是encoder-only transformer(只有编码器部分的Transformer,没有解码器),结构与T5编码器高度一致,在大量多样化的真实时序数据上预训练。它通过上下文学习和分组注意力机制(group attention,一种让模型关注相关历史区间和协变量的机制)生成多步概率预测,不需要在你的数据上微调。
三个特性让它适合大规模库存预测:
1. **零样本泛化**:新SKU无需训练任务。历史销售窗口进去,概率预测出来——包括历史稀疏或很短的产品也适用。
2. **协变量支持**:Chronos2接受过去协变量(只有历史期已知的特征)和已知协变量(预测区间内未来值已给定的特征,比如计划中的促销或价格变化)。在Python API里,通过`context_df`和`future_df`数据框传给`pipeline.predict_df()`。协变量把模型从单变量预测器变成条件预测器。
3. **What-if情景分析**:因为协变量是显式输入,你可以生成多个预测——做促销和不做促销、现价和折扣价——在下单前对比。
Chronos2同时满足这三个需求:零样本推理、通过`predict_df()` API显式支持过去和未来协变量、一条点击部署路径到SageMaker Serverless Inference。这意味着接入新品只需要数据——不改管道、不进模型注册表、不考虑重训计划。架构详解里引入的评估器框架,让任何替代预测模型都能在同一轨迹上做基准测试,不用重建管道。
为什么多智能体优于单体
如果用一个单一LLM提示词执行所有推理步骤——数据加载、协变量选择、预测解释、订单计算、验证、保存结果——对大目录来说会超出实际上下文窗口限制,没法在组件层面做单元测试,任何一步出错都会整体崩溃。按照"每个推理职责一个智能体"的架构则直接解决这些问题。
关键是这个架构做了严格区分:**LLM智能体负责判断,确定性工具负责计算**。Bedrock推理恰好发生在四个地方:四个智能体。它们协调的操作(加载文件、跑补货公式、生成图表、写入S3)都是普通Python函数,智能体通过`@tool`装饰器调用。智能体决定何时调用哪个工具、带什么参数:工具本身不包含LLM推理。
这个分离让每次运行的LLM成本可控、推理质量高,因为每个智能体只处理自己专业领域里的一小段任务,而不是让它把整个流程塞进一个提示词里。同时,因为工具是确定性函数,你可以对每一步单独测试、审计、复现——这在单体提示词方案里几乎不可能。
对我们有什么用?
这套模式最直接的应用场景不只是库存管理。任何需要"模型预测+业务规则+多方校验+结果留痕"的流程,都可以借鉴这个架构:比如供应链需求规划、容量规划、预算分配、甚至营销活动效果预测。核心思路就三条:
- 用一个零样本基础模型干掉每个个体的训练成本,让"新增一个实体"从"几周ML工程"变成"传个CSV"。
- 把判断(什么时候用什么工具、怎么解释结果)交给LLM,把计算(公式、校验、读写)留给普通函数,这样成本可控、可测试、可审计。
- 用多智能体分工而不是一个超大提示词,降低上下文压力,故障也能隔离在单个智能体里。
踩坑提醒:协变量设计是核心,你得把业务里"未来已知事件"(促销、价格变化、节假日)显式编码成特征;确定性工具边界要划清楚,不该让LLM自己去执行计算;最后,评估器很重要——换预测模型时用同一套历史traces对比,别凭感觉换模型。这套架构最让我意外的是,成本降这么狠的同时,准确率(WAPE 12.3%)已经够满足日常补货决策——零样本不是"凑合能用",而是真的能放进生产流程。如果你们团队也在做类似预测+决策的自动化,这值得直接抄作业。
内容与图片版权归原作者所有 · 原文: https://aws.amazon.com/blogs/architecture/from-zero-shot-forecast-to-purchase-order-with-amazon-bedrock-agentcore/