 devgo.cn
想象一个第一次打开Airbnb、还没登录的用户:他没有搜索历史,没有过往订单,甚至可能只是从广告链接跳进来。传统的推荐模型全靠user_id串联起这个人过去的每一次点击、搜索和预订,面对这样一位“陌生人”,模型几乎拿不到任何信号,只能给出千篇一律的默认结果——你从北京打开首页看到的推荐,和从纽约打开的人一模一样。这个场景并不罕见:Airbnb有相当一部分流量来自付费广告和自然搜索,这些用户大量处于未登录或首次访问状态,而且隐私法规(比如GDPR)又限制了使用跨站追踪标识符。个性化似乎走进了死胡同。Airbnb团队给出的解法很有意思:既然认不出“你是谁”,那就看“你在哪”。他们发现,从同一座城市或同一个街区浏览Airbnb的用户,在搜索目的地、价格区间和旅行模式上高度相似——首尔用户大概率会搜济州岛或大阪,而纽约用户更倾向加勒比或欧洲。这个规律和个体的历史记录无关,只要拿到IP对应的粗略地理位置就够了。基于这个洞察,他们设计了一套叫Proximity Features(邻近特征)的机制:把地理位置邻近的用户聚成一组,每组约1000人,聚合这一组的集体行为(比如最近搜过的热门目的地、房型偏好、价格中位数、过去预订过的地点和出行人数等),生成一个特征向量,任何新用户一进来,就能直接借用这1000个邻居的信号,不需要任何持久化身份标识。
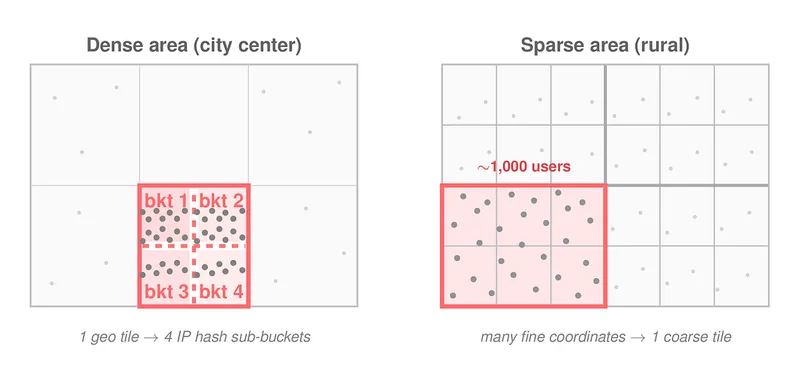
核心的技术难点在于如何分组。全球Airbnb用户的密度差异巨大:机场附近一天可能有几万人,而乡村地区可能只有寥寥几个。如果用地理解析的固定网格(比如固定分辨率的geohash)来分组,城市里太粗、乡村里太细,两头不讨好。作者用了一个两阶段自适应聚类算法:对密度足够的区域,先用IP哈希桶进一步细分成更小的小组,保住城市中心的精细度;对稀疏区域,则逐步扩大地理块(multi-pass coarsening),直到聚齐大约1000人。效果就像一张能自适应缩放的地图——大城市是细密网格,乡村是大块区域。
就直观展示了这种“稠密缩放、稀疏扩展”的聚类逻辑,左半边是城市里细划分,右半边是乡村的粗合并。
另一个工程亮点是近邻键(proximity key)的设计。它是一个紧凑的分组键,表示一个约1000人的地理簇:由量化后的经纬度瓦片,加上对人口密集区额外的IP哈希桶索引组成。它本质上只是一个“邻居组”的标识,而不是某个人——任何ML模型原本依赖user_id的地方,都可以换成这个近邻键来服务冷启动用户。而且这个分组是稳定存在的——2023年启动的分区到现在还能直接用,每天只需刷新新增IP和坐标漂移。查询时,用户的IP实时解析到近邻键,从分布式键值存储里取特征,整个过程是个“软依赖”:万一查询超时,模型就跳过这步继续跑,绝不会阻塞核心请求路径。考虑到隐私,设计上也是层层保护:每个特征都反映的是约1000人群体的行为,绝不指向个人;聚类输入自动排除未同意被追踪的用户;地理位置是粗粒度聚集的,偏向人口中心而非具体地址;整个流程还对接了同意管理和数据删除的合规要求。
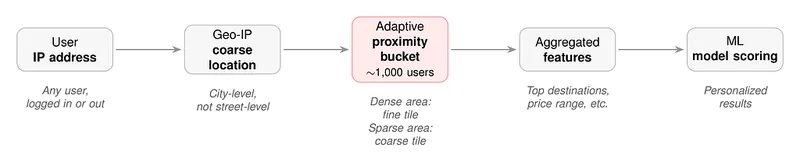
显示的是这套隐私设计的层次。
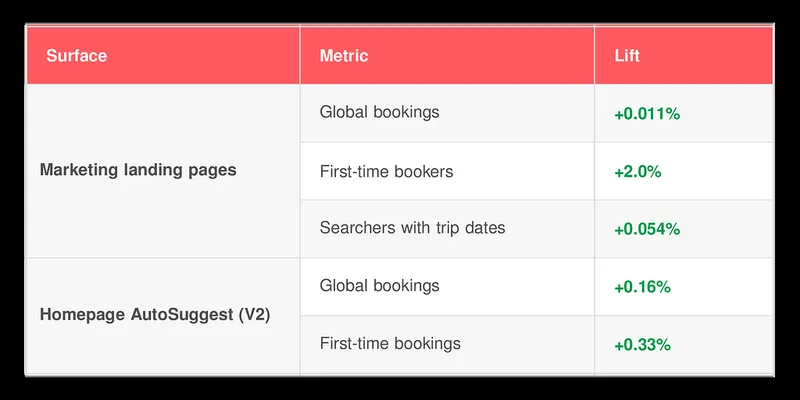
效果是实打实的。目前Proximity Features已经上线在多个Airbnb页面,由生产环境的A/B实验验证了提升。比如营销落地页(用户从广告或搜索跳转来的页面)冷启动率特别高,之前推荐模型因为特征太稀疏,只能给静态的房源卡片;加上邻近特征后,模型能根据周围人的浏览和预订偏好来排序。
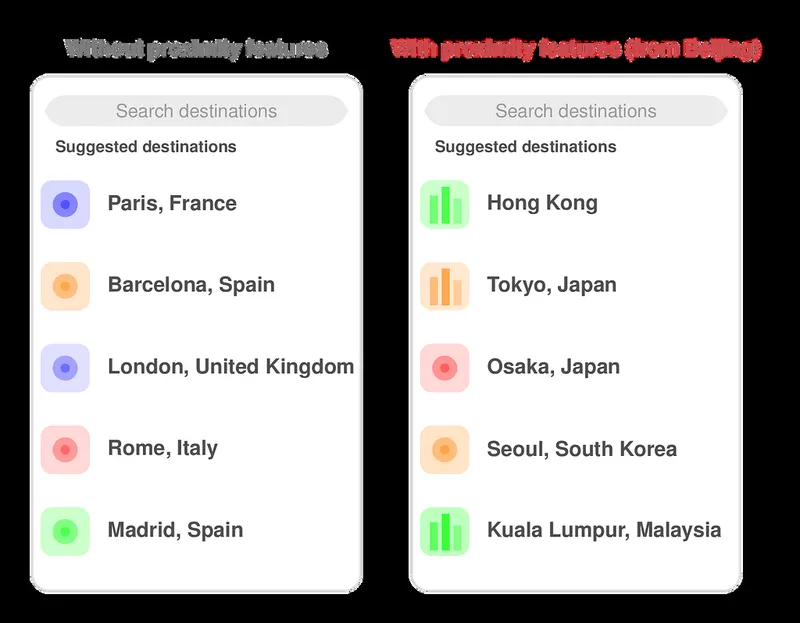
展示了几个实验的相对提升幅度。首页的AutoSuggest(就是搜索框下的自动推荐)也很典型:以前没历史记录的用户只能看一个全球通用的固定列表(巴黎、巴塞罗那、伦敦、罗马),现在换成位置感知信号后,一个来自北京的新用户会看到香港和东京。
就是这样一个示例——同样没有任何个人历史,推荐结果却因为IP归属地被盘活了。
最让我意外的是这个思路的可迁移性:它本质上是在“个体信号稀缺”时,用地理邻近性作为代理特征,把“群体行为”安全地转让给个体。这在电商、内容社区、本地生活服务里几乎都能直接套用。但要注意几个坑:一是分组的粒度要自适应,固定网格在城市和乡村都会失效;二是特征要有合适的时效性——这里按天计算,短期参与和长期模式分开用;三是数据管道必须把隐私设计嵌入每一层,而不是事后补救;四是软依赖能避免故障传导,让个性化永远不阻塞主流程。如果你正在处理冷启动和受隐私约束的多方数据,这个“用人群特征替代个体标识”的框架很值得借鉴。
是这套机制在实际流量中的另一个案例说明,感兴趣的话可以对照原文看更多细节。
内容与图片版权归原作者所有 · 原文: https://medium.com/airbnb-engineering/personalization-without-user-identity-8e7891a1d486?source=rss----53c7c27702d5---4