 devgo.cn
想象你正在维护一个大型代码仓库,老板让你修一个失败的测试,你需要在仓库里翻找、运行测试、改代码、再验证,整个过程可能要折腾几个小时。传统对话式模型只能回答单个问题,没法记住你在中间做过什么,更不会自己动手改文件、跑终端命令。现在,Accio-Lab 发布的 Occamy-1.0 就是专门为这种长程协作场景设计的开源模型(Apache 2.0 协议),它不是一个只会聊天的助手,而是一个能协调搜索、代码、终端、文件、API、工具调用的多步骤工作者,并且在几十上百次交互中持续跟踪状态。
先说架构。Occamy-1.0 用的是混合专家(Mixture-of-Experts,MoE)架构,就是模型内部有很多个小的专家子网络,每个 token 只激活其中几个,而不是全部参数都参与计算。它总参数 35B(即 350 亿),但每处理一个 token 只激活 3B 参数,这样计算量大幅降低,推理速度更快、成本更低。具体配置是 40 层、256 个专家,其中每个 token 走 8 个路由专家加上 1 个共享专家。它还带了一个视觉编码器,支持图像输入,基础上下文长度是 262,144 个 token(相当于一本书的容量),监督微调时用到了 131,072 的序列。训练基础是 Qwen3.6-35B-A3B 的检查点,然后做了全参数 SFT(监督微调,用标注好的输入输出对来教模型)、HDPO(一种偏好优化算法,让输出更符合人类偏好)、模型合并和 SAO 后训练。整个训练数据里包含 14,998 条可执行且带等级评分的轨迹,总共 403.3M tokens。
为什么特意强调“可执行、带评分”?因为长程 Agent 任务不像普通聊天那样只看回复漂不漂亮,而是要真的去操作环境、观察状态变化、判断任务是否完成。Occamy 的训练数据里有大量真实的工具调用轨迹,每个轨迹都按照最终任务完成情况打分,这就逼着模型学会执行——而不是只会说“好的,我改好了”。部署也不复杂,标准 Transformers 兼容的服务栈都能跑,官方推荐用 SGLang 0.5.10+ 或 vLLM 0.19.0+。

这套设计在几个典型场景里展现了明显优势。第一个是长时运行的软件工程任务:给它一个仓库、终端工具、测试和文件访问权,让它去检查代码、找到失败的测试、实现修复、跑验证、再解释改动。这种多步骤编码工作比单轮代码补全要难得多,因为模型必须记住中间状态,还要能自己恢复错误。终端和软件工程数据贡献了 1,228 条轨迹,平均每条 35.1K tokens,在 Terminal-Bench 2.1 上得了 59.00 分。第二个是工具驱动的业务工作流,比如对账、从多个数据源整理报告、验证后更新业务系统——这些场景需要结构化 API、文件、表单和决策跨很多次调用协同。工具调用数据有 7,429 条轨迹(67.7M tokens),AutomationBench 的通过率是 27.60,部分指标 69.10,Business Arena 得分 $79,868(分数代表模拟业务中赚到的钱)。第三个是长会话协作,要求 Agent 在长时间内保持目标、中间状态和委托出去的工作。这部分数据平均每条 95.8K tokens,共 88.4M tokens,训练重点就是跨工具调用、委托运行和上下文压缩(把已处理过的历史总结成更短的摘要)保持连续性。第四个是搜索加行动的工作流,比如查资料、调用工具、改文件、把发现转成可交付成果——通用 agent 数据有 5,418 条轨迹(204.1M tokens),Claw-Eval 平均分 82.20,通过率 71.40,WildClawBench 49.16。
当然,它并不是全能的。论文和模型卡也诚实指出了短板:检索密集的任务(比如需要大量网页搜索)还有提升空间,原生的浏览器视觉交互和桌面视觉控制完全不在当前训练接口里,如果你需要靠截图导航、鼠标控制或视觉浏览器操作,那就得另找专门的控制器。对比一下前沿模型:Claw-Eval 平均 82.20 vs Qwen3.8-Max 的 83.92 和 GPT-5.6 Sol 的 81.80,WildClawBench 49.16 vs GPT-5.6 Sol 的 67.20,OfficeQA Pro 48.10 vs Qwen3.8-Max 的 74.40,BFCL v4 65.40 vs Qwen3.8-Max 的 73.65。这些数字说明 Occamy 走的是“成本-能力”的性价比路线,不是全面碾压。还有一点要注意:官方没有公布推理速度、延迟目标、batch size 建议或具体 VRAM 需求,虽然 3B 激活参数比稠密 35B 模型每 token 计算量小,但 35B 总参数量、长上下文、视觉组件和推理框架的开销都会吃显存。上下文长度官方说基础架构支持 262,144,但 SFT 时用了 131,072,实际部署以发布的 checkpoint 配置为准,别指望每个量化版都能完整支持那个长度。
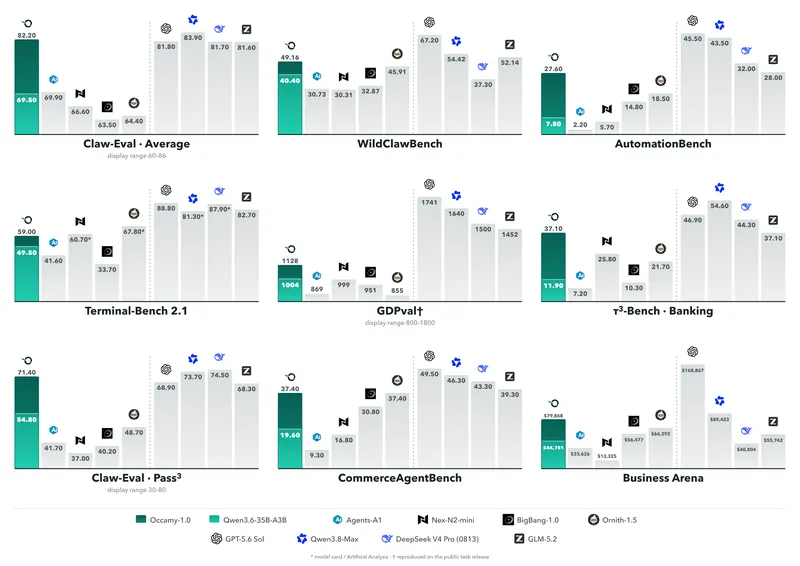
如果你正在做需要持续协作的 Agent 产品,比如自动修 issue 的机器人、能跨多步操作业务系统的自动化助手,或者一个要在一段长对话里不断执行工具任务的内部工具,Occamy-1.0 是个很合适的开源底座。它的价值不在某个单项评测刷分,而在“执行可靠性、状态追踪、错误恢复、低成本计算”这套组合拳。实际用的时候有两点坑要提醒:一是长上下文会显著增加内存和延迟,尽量用上下文压缩来管理历史;二是它带工具访问能力,能改文件、调 API、做业务操作,所以务必做好沙箱隔离、权限控制、步骤验证和人工审核,别让它直接连着生产环境乱跑。另外,官方按照 Apache 2.0 发布,但模型权重细则要看 Hugging Face 模型卡,商业部署和二次分发之前一定先读一遍。对比同类模型怎么选?如果主任务是开源权重深度搜索,那 XYZ-Aquila-mini 更合适;如果更需要小规模多模态部署,Obsidian-3B-V0.5 更轻;如果是自动驾驶研究,Alpamayo-1.5-10B 的视觉推理更对口。简单说,Occamy 给你的是一个能长时间干活、扛得住多步骤折腾的开源 Agent 引擎,剩下的安全护栏和场景适配,得你自己来搭。
内容与图片版权归原作者所有 · 原文: https://hackernoon.com/occamy-10-an-open-agentic-model-built-for-long-horizon-work?source=rss