 devgo.cn
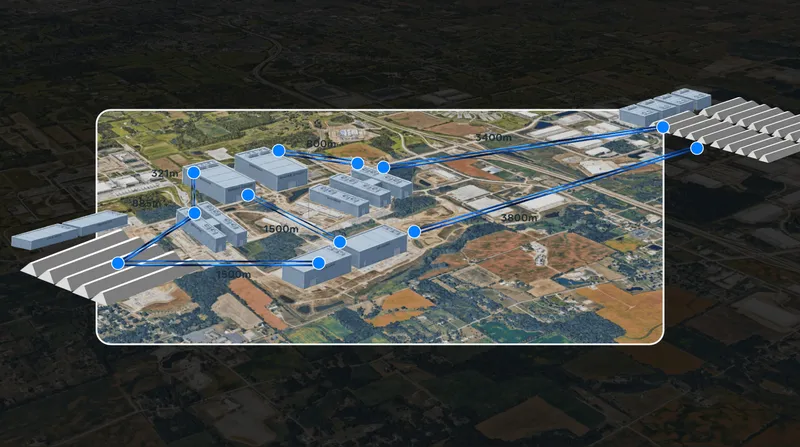
当你的训练任务需要几十万张 GPU 协同工作时,最怕的不是单卡算力不够,而是某个节点掉链子拖垮整个任务。Meta 在俄亥俄州 New Albany 打造的 Prometheus 超算集群,第一阶段已经完工并用于训练其最新的 Muse 系列基础模型,最终目标是把约 100 万张 GPU 像一台机器一样协同运转。这个规模意味着,任何一个微小的硬件故障或网络拥塞,都可能导致数万 GPU 小时的计算资源白白浪费。
训练大模型和跑传统 Web 服务有个本质区别:Web 服务里各个服务器之间是松耦合的,请求和响应之间不需要高带宽、低延迟的紧密同步;但大规模 AI 训练要求所有 GPU 步调一致地协同计算,网络成了决定训练效率的关键瓶颈。Meta 为此在标准数据中心网络之外,专门建了一张独立的以太网,叫 Back-End(BE)网络,专门负责 GPU 之间的直接通信,无论是同一栋楼内还是跨楼。
训练任务本身也有层级结构:数据并行会把训练拆成多个模型副本,副本内部的计算对延迟和带宽极其敏感,而副本之间的通信则相对容忍延迟。Meta 的网络设计正好匹配这个层级——楼内用低延迟高带宽的交换结构,楼间用聚合网络连接。他们还和 Meta Superintelligence Labs 紧密配合,优化并行策略、通信模式和算法,尽量让 GPU 不闲着等网络。这套思路在早期的 24K GPU 集群和 100K+ GPU 的区域级集群上验证过,Prometheus 把它推到了新的规模和距离。
硬件选型上,Prometheus 目前部署了两代 NVIDIA GPU 平台,第三代基于 Vera Rubin NVL72 的也快到了。第一代叫 Catalina,用的是 GB200 NVL72 的 Ariel 变体,一个很有意思的决策是:GB200 的 scale-out 带宽(GPU 之间通过网络通信的带宽)只有 400G,而其他维度(算力、显存带宽、域内互联带宽)都比上一代 H100 大幅提升,Meta 认为这种不平衡会拖累性能,所以选择了每 GPU 配 800G I/O 的配置,比行业更早用上 800G 网络。Catalina 每个域包含 72 张 Blackwell GPU,13.4 TB HBM3e 显存,FP8 训练算力 720 PFLOPS,域内 NVLink 带宽 130 TB/s,整个双机架功耗约 120 kW。
第二代叫 Clemente,升级到 GB300 NVL72,每 GPU 显存从 192 GB 涨到 288 GB,FP4 算力翻倍,注意力(softmax)加速也翻倍。更重要的是,GB300 原生支持每 GPU 800G 网络,不再需要像 Ariel 那样额外配置,GPU 与 CPU 的比例也变成 2:1,可以把完整的 72-GPU 域塞进单个机架,部署更简洁,线缆更少,维护更方便。Clemente 单机架功耗约 135 kW,性能比 GB200 提升 5-10%。
这么大的集群,散热是个大问题。Prometheus 采用了闭环液冷技术,Clemente 既可以用模块化的风助液冷(AALC),也可以用新数据中心里的设施液冷(FLC)。
最让我意外的是他们对稳定性的执着。大规模训练任务里,一台主机出问题就可能拖慢甚至中断整个任务,所以他们专门盯着一个叫 goodput 的指标——真正有效计算的时间占比。通过提升系统稳定性和可靠性,Muse Wonder 模型的预训练 goodput 超过了 85%,强化学习(RL,就是让模型通过试错和奖励信号来学习)运行更是超过了 90%。训练期间,两次中断之间的平均间隔(MTBI,可以理解为系统能稳定跑多久不出岔子)达到了约 4.7 万 GPU 小时,之后又通过固件修复把整个集群的 MTBI 提升到超过 5.4 万 GPU 小时。
这套思路对任何做大规模分布式系统的人都有直接参考价值:网络设计要匹配通信模式,硬件选型要看到瓶颈而不只是峰值算力,稳定性指标要量化到能指导优化。如果你在搭自己的训练集群,哪怕规模小得多,也可以想想:你的网络是不是瓶颈?你的任务对延迟和带宽的敏感度分布是怎样的?你有没有一个像 goodput 这样的指标来衡量系统真实效率?这些问题的答案,往往比单纯堆硬件更能决定训练能跑多快。
内容与图片版权归原作者所有 · 原文: https://engineering.fb.com/2026/10/19/data-center-engineering/inside-prometheus-meta-gigawatt-scale-supercluster/