 devgo.cn
想象一下,你要上线一个全新的搜索功能,用户可以用自然语言表达意图,比如“能滑雪的浪漫小木屋”或者“可住八人的宠物友好海景房”。但问题来了:这个功能上线前,系统里一条真实用户搜索词都没有,更别提“哪些房源匹配这些搜索词”的标注数据了。没有历史流量,模型拿什么训练?这就是 Airbnb 在引入自然语言搜索时遇到的冷启动问题,也是 CASTLE 这篇论文要解决的核心难题。
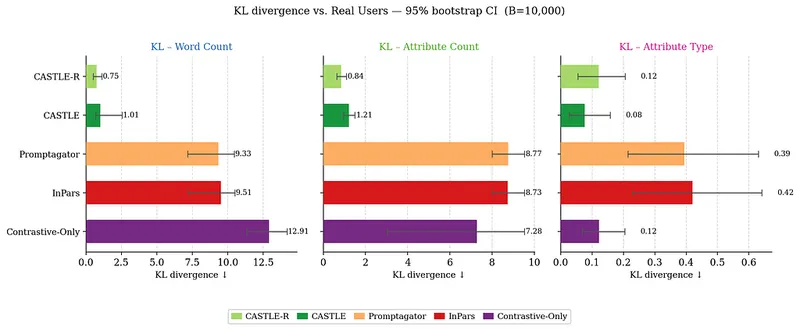
冷启动的难点在于,合成训练数据不是“造几句像人话的搜索词”那么简单。如果生成的搜索词分布和真实用户行为对不上——比如真实用户习惯搜 4 到 8 个词的短语,而模型生成的是冗长的完整句子——那训练出来的模型上线后必然水土不服。作者用 KL 散度(衡量两个概率分布差异的指标)来量化这种偏差,发现之前的 InPars、Promptagator 等方法,合成查询与真实用户分布的 KL 散度在 9.33 到 26.2 之间,差距巨大。而且,光生成查询还不够,还得知道哪些房源和这个查询相关,这又是一层标注难题。
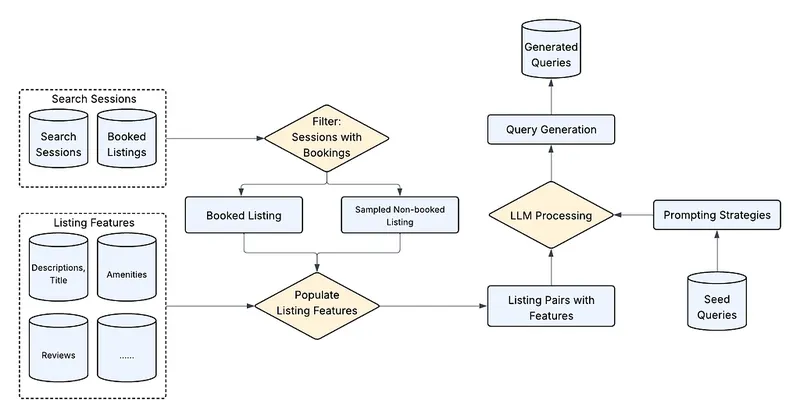
CASTLE 的思路很巧妙,它把两个问题用一个机制同时解决:对比式房源对。Airbnb 有海量的预订会话数据——用户浏览了好几个房源,最终只订了其中一个。这个行为本身就隐含了偏好:被预订的房源优于其他被浏览但未预订的。于是,CASTLE 把“被预订的房源”作为正样本,从“浏览过但没订的”里随机抽一个作为负样本,组成(正,负)房源对,作为结构化输入喂给大语言模型(LLM,就是 GPT 这类能理解和生成自然语言的模型)。房源特征包括设施、属性,以及脱敏后的近期公开评论摘要。
关键点来了:作者让 LLM 生成一个“正房源满足、负房源不满足”的查询。因为正负样本由真实用户行为决定,而不是 LLM 自己拍脑袋,所以生成的查询天然自带正确的相关性标签——不需要事后人工标注,也不存在“模型自己生成数据又自己验证”的循环论证。这就像让 LLM 做一道有标准答案的题,答案由真实预订行为锁定,LLM 只是负责把这道题的“题干”(查询)写出来。
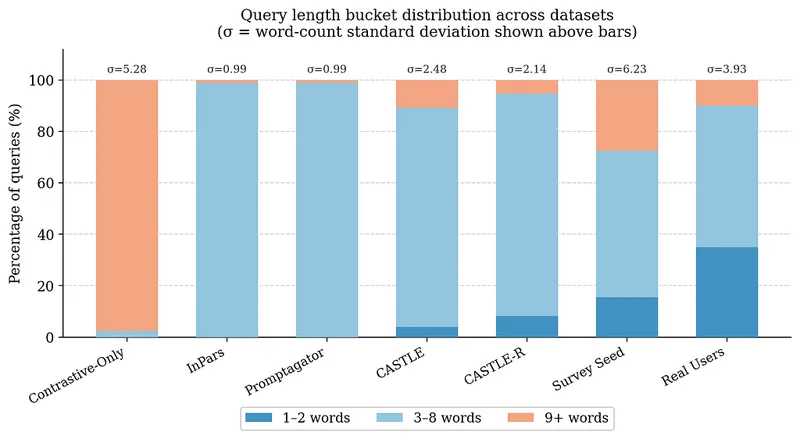
为了最大化查询的覆盖面和真实感,CASTLE 用了三种提示词变体:模板式提示保证结构多样性;少样本提示用约 500 条来自用户调研的真实种子查询作为语言范例,让生成结果贴近真实客人的措辞;属性引导提示则聚焦两个房源之间的具体差异点,比如壁炉或离滑雪场近。还有一个显式的多样性机制,防止模型“查询坍缩”——就是无约束的 LLM 反复生成同一个短句。效果很直观:CASTLE 生成的查询词数分布标准差 σ=2.48,和真实用户的 2.49 几乎一致,而基线方法只有 0.99。
结果方面,CASTLE 在 KL 散度上做到 1.01,比最好的基线(Promptagator 的 9.33)提升了 9.2 倍。更意外的是,在属性类型层面,CASTLE 的 KL 散度 0.08 甚至低于人工精心设计的种子查询(0.09)——也就是说,生成的数据比人工设计的还贴近真实用户意图的多样性。标签质量也经得起检验:三位独立专家评审了 200 个样本三元组,对 CASTLE 相关性标注的认同率高达 91% 到 93%,全程没有人工标注参与。
最让我意外的是,CASTLE 的价值不止于冷启动阶段。因为生成过程是基于具体房源特征条件的,它天然会过采样长尾意图——那些在自然流量里很少出现、但一旦出现就很重要的需求,比如某种罕见的房型或设施组合。这意味着,即使真实流量积累起来后,CASTLE 的合成数据依然能补充真实数据覆盖不到的角落。
这个思路对任何做搜索、推荐或者意图理解系统的团队都有直接借鉴意义。核心启发是:别把“生成查询”和“生成标签”当成两件事分开做,而是找一个能同时锚定两者的行为信号——预订行为、点击行为、收藏行为都可以。用真实行为做锚,用 LLM 做发散,两者互补而不是竞争。要注意的坑是:行为信号要选得准,正负样本的定义必须反映真实偏好,否则“正确性由构造保证”就成了空话;另外,生成分布一定要对齐真实用户习惯,Airbnb 用户偏好 4 到 8 词的短语,你的用户可能偏好长句,得用真实数据校准。
内容与图片版权归原作者所有 · 原文: https://medium.com/airbnb-engineering/castle-training-natural-language-search-before-the-first-real-query-3818ef8b4828?source=rss----53c7c27702d5---4