 devgo.cn
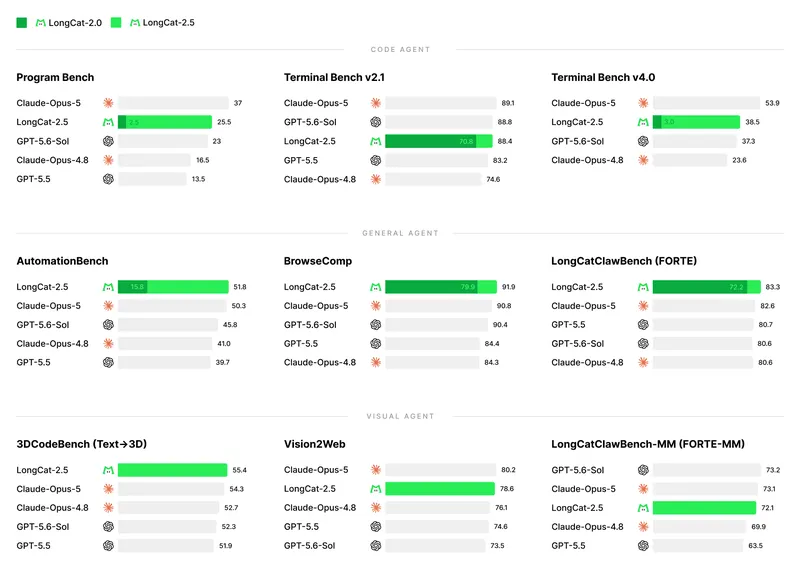
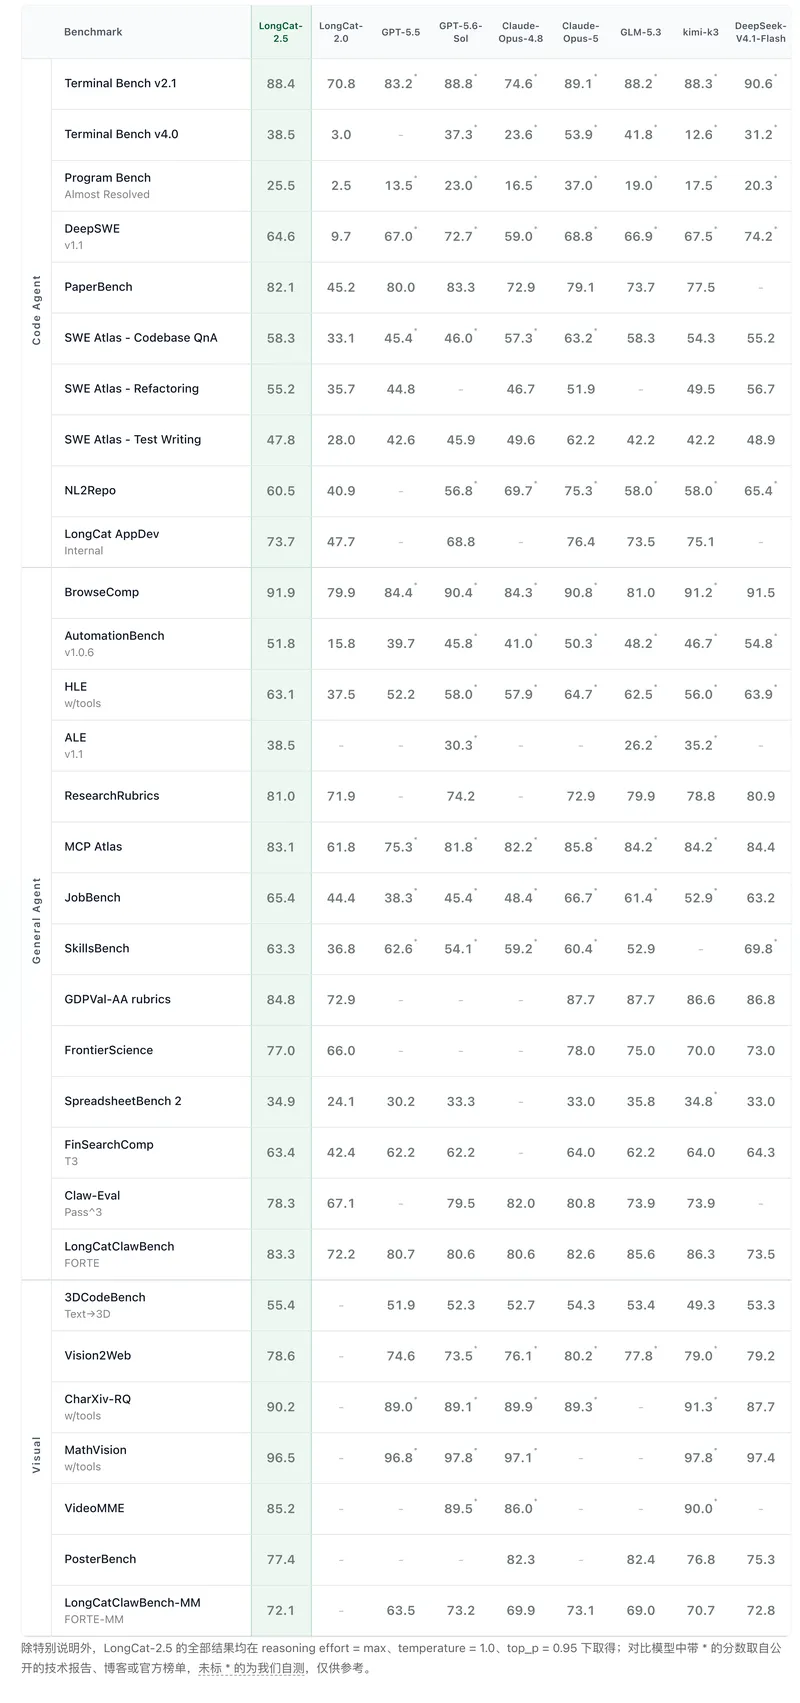
如果你正在做大模型应用,大概率已经感受到一个尴尬:模型在单轮问答上越来越聪明,可一旦让它去完成一个需要几十步、跨多个文件、还要自己查资料改代码的长任务,它就开始犯迷糊——做着做着忘了前面干了啥,或者在一个错误方向上反复打转。美团这次发布的 LongCat-2.5,就是冲着这个痛点去的。它是个 1.6 万亿总参数、每个 token 激活约 480 亿参数的 MoE 多模态模型,但真正值得关注的不是参数规模,而是它把三件原本很难兼得的事揉进了一条训练链路:原生视觉理解、长程智能体任务、以及国产算力上的高效训练推理。
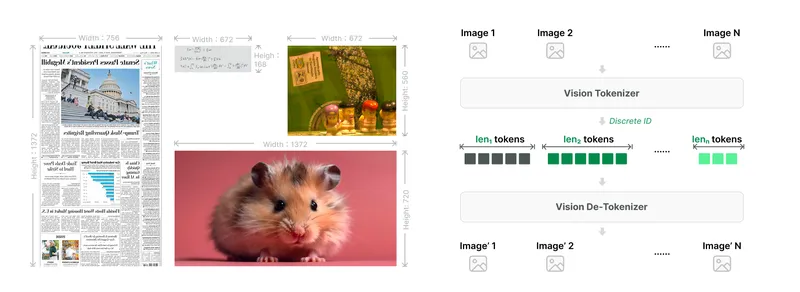
先说视觉这块。大多数多模态模型是把图片丢给一个独立的视觉编码器,编码成向量再拼进文本序列,LongCat-2.5 的做法不一样——它把视觉信号直接表示成多层级离散 token,也就是把图像像文本一样切成一个个离散的符号。这样主干模型就能用统一的 token 形式同时处理视觉和文本,不需要在训练时单独跑一个视觉编码器,计算图更干净,也方便做长序列的打包和切分。
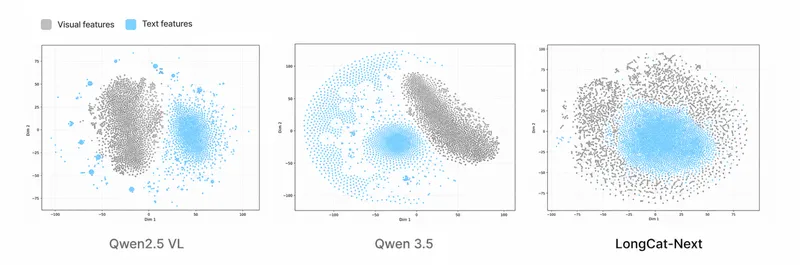
具体实现上,它沿用 LongCat-Next 的思路,对语义对齐编码器(SAE,一个专门把图像特征和文本语义对齐的编码器)产生的原生分辨率特征做残差向量量化(RVQ,一种把连续向量逐步压缩成离散码本索引的方法),把图像变成一串离散 token。因为 tokenizer 是固定的,视觉 token 可以离线预计算并缓存,训练时主干模型直接吃现成的 token ID,省掉了在线视觉计算,也缓解了分布式训练里不同设备负载不均的问题。作者在平均激活参数约 3B 的小规模 MoE 模型上做了验证,发现视觉和文本的 embedding 在 t-SNE 可视化里呈交织分布,说明两者确实在共享语义空间里融合了,而不是各占一块。
再说智能体强化学习,这是 LongCat-2.5 提升最明显的地方。长程智能体任务难在哪?难在训练数据不好造、环境不好搭、奖励不好给。一个真实任务可能要改好几个文件、跑测试、看报错、再改,这种轨迹数据靠人工标注根本不现实。LongCat-2.5 的做法是构建可扩展的数据合成流水线:从 GitHub 公开仓库和内部真实场景里筛 PR 和关联 issue,用 Agent 自动打标、合成可交互环境,并生成可验证的测试用例,用 fail-to-pass(F2P,指一个测试用例在修复前失败、修复后通过)和 pass-to-pass(P2P,指修复前后都通过的测试)来校验。RL 训练时,实时 rollout 的轨迹和通过率又反过来辅助二次打标,基于假阴、假阳分析持续修正测试用例,让验证信号越来越准。
训练长程任务还有个工程难题:一条轨迹可能特别长,如果等整条轨迹跑完再更新梯度,效率太低。LongCat-2.5 用 partial rollout 异步训练策略——每个 RL step 保持一定过采样率,凑齐批次后中断、保存未完成轨迹,下一采样阶段再恢复。但这样会带来样本陈旧性问题:同一轨迹的不同 token 可能来自不同历史 checkpoint,梯度信号不一致。他们的解法是裁剪采样时与当前训练时 logprob(模型给某个 token 的概率的对数)的差异,并基于历史累计差异调整每个 token 的梯度贡献,限制陈旧性带来的偏置。另外,为了防止 reward hacking(模型钻奖励函数的空子,比如假装完成任务),他们在任务环境里断网、清除 git 历史和文件缓存,还引入 LLM judge 监督轨迹,对重复思考和重复工具调用施加额外惩罚。
多专家在线教学(MOPD)这块也值得一说。LongCat-2.5 沿用 LongCat-2.0 的专家组机制,分别优化 Agent 能力、推理能力和交互体验。学生模型在各领域任务里在线采样,领域专家通过采样结果上的全词表 KL 散度(一种衡量两个概率分布差异的指标)来训练学生。这里有个分布偏移的问题:如果学生采样的上下文和专家训练时见过的轨迹差太远,学习信号就不可靠。他们的做法是把每轮教师回复按固定长度拆成 per-cut prefix,并限制学生自采样的最大长度,这样学生采样的分布和教师轨迹更接近。
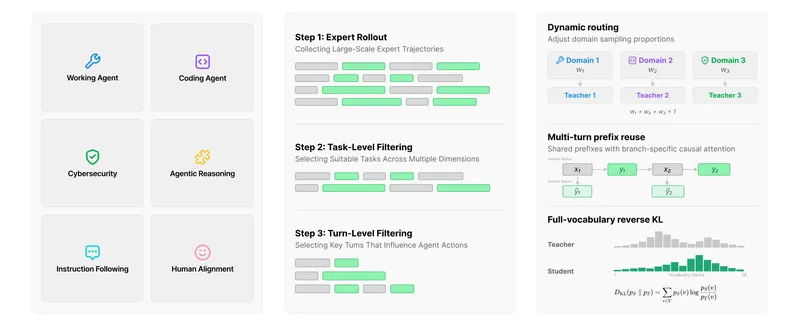
为了控制计算成本,同一教师轨迹的 prefix 被分到同一推理引擎,共享 prefill 计算和 KV cache(大模型推理时缓存中间计算结果的机制,让回答更快),训练时以教师轨迹为树干、学生采样为分支构建树,用 Tree Attention 一次前传反传完成所有样本的训练。
训练基础设施上,LongCat-2.5 针对国产算力单卡显存不足 80GB 的限制做了大量优化。并行策略上,FSDP(一种把模型参数分片到多张卡上的数据并行方法)和 EP(专家并行,MoE 模型里把不同专家分到不同卡上)的并行度都和单个超节点的卡数一致,让参数 AllGather、专家 token AllToAll 都在超节点内的高带宽互联域里完成。还引入了双重分片 FSDP:模型参数在 FSDP 域内分片,FP32 主权重和优化器状态通过 HSDP 副本进一步跨 FSDP 域分片,降低常驻显存。针对 MoE 里专家负载不均衡的问题,基于 MoonEP 引入阈值触发的动态专家复制机制——只有负载不均衡程度达到阈值才启用复制,避免通信开销超过收益。这套 FSDP 配置在长序列 SFT 任务里,单卡吞吐量比 DDP 基线提升了 86%。
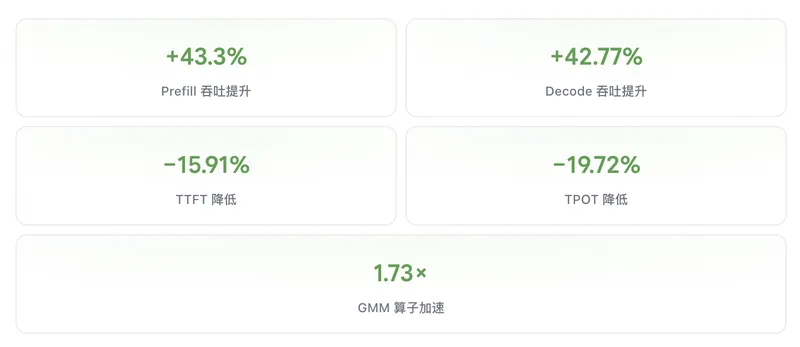
推理侧,LongCat-2.5 构建了 W4A4 高效推理方案,把专家权重和激活同时量化到 4 bit,用原生 INT4 矩阵乘法单元计算。精度上以 FlatQuant 的可学习等价变换为基础优化 MoE 量化精度,保持和量化前相当的表现。系统层面针对 prefill 和 decode 的不同特点优化计算与通信的流水重叠。线上压测里,相对 W8A8 INT8 基线,prefill 和 decode 吞吐分别提升 43.3% 和 42.77%,TTFT(首 token 延迟)和 TPOT(每个输出 token 的延迟)分别降低 15.91% 和 19.72%。
另外他们还做了训推精度一致性方案,让训练、Prefill、Decode 可以独立选择并行配置,同时保持逐 token logprob 的 bitwise 一致,这为算子迭代提供了统一的数值回归基准。
最让我意外的是他们把真实 Agent 的失败轨迹也转化成了训练数据——把失败案例变成可复现、可验证的训练任务,针对模型能力短板持续补充数据。这个思路其实很多团队都能借鉴:不要只盯着成功轨迹,失败轨迹里往往藏着模型最需要补的课。如果你在做 Agent 相关的训练或评测,可以重点关注他们的数据合成流水线和 F2P/P2P 测试校验机制;如果你在国产算力上训练长上下文模型,双重分片 FSDP 和动态专家复制的思路可以直接参考;如果你在做长上下文推理服务,PD 分离加容量感知调度、跨层 KV 卸载这些手段对降低延迟和提升吞吐都很有用。当然,这套方案依赖大量自研基础设施,小团队未必能全盘照搬,但其中"把视觉 token 化、把失败轨迹数据化、把训推一致性做成默认配置"这几个思路,是通用的。
内容与图片版权归原作者所有 · 原文: https://tech.meituan.com/2026/11/02/Meituan-LongCat-2.5.html