 devgo.cn
三年前,想克隆自己的声音,需要录好几个小时的语音,再借助一堆专业工具,才能勉强生成一句听起来有点像我、但仔细听还是假的短句。现在呢?几秒钟的音频,点几下鼠标,一个几乎以假乱真的声音克隆就完成了——而且,除非是专家,普通人根本分辨不出来。
这不是科幻片,是已经发生的现实。加州大学伯克利分校研究 AI 语音克隆的博士生 Sarah Barrington 说,现在有些平台甚至宣称只需要 3 秒的语音样本就能生成克隆。她在课堂上演示过,用一段 YouTube 视频里的自己的声音,90 秒就完成了克隆。
这项技术门槛的断崖式下降,直接催生了一个黑色产业:电信诈骗。路透社 9 月报道,有人冒充律师,用克隆声音说服一家意大利大型私人银行,向境外电汇了约 9500 万欧元(约合 1.05 亿美元)。
问题来了:我们的耳朵,真的能听出克隆声音和真人的区别吗?
答案很残酷:基本听不出来。Barrington 和同事做了一项研究,把 220 位不同说话者的真实声音和克隆声音放给 600 多人听。其中一半听众被要求指出哪些是 AI 生成的,他们猜对的概率只有 60%——比抛硬币好一点,但远不够可靠。另一半听众同时听到克隆声音和真人声音,让他们判断是不是同一个人,结果有 80% 的人认为就是同一个人。
过去,克隆声音有个致命破绽:太完美了。没有呼吸声,没有停顿,没有“嗯”“啊”这类语气词,听起来像机器人念稿。但现在,这些破绽已经被技术填平了。AI 模型学会了故意加入呼吸声、语气词和语调变化,让克隆声音听起来更自然。
那怎么办?研究者把目光转向了声音本身——声波。
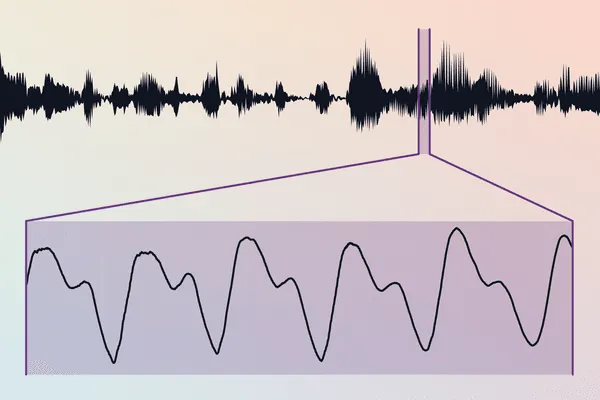
这就是音频取证(audio forensics)的用武之地。把声波放大到足够细,你能看到声带每次振动的微小起伏,在波形图上表现为一个个重复的凸起。这些振动周期长度的微小变化叫抖动(jitter),峰值高度的微小变化叫闪烁(shimmer)。这些特征组合在一起,可以被检测模型用来判断一段声音是不是 AI 生成的。
我自己也做了个实验。我录了 24 句话,然后让克隆工具生成同样的句子,逐句对比。结果很有意思:在开着暖气、有背景噪音的环境下录的句子,克隆版的抖动和我的在统计上几乎没有区别,但闪烁更稳定。而在安静房间里录的句子,克隆版反而更“干净”——12 句话全部如此,音调下方的噪声更少,即使模拟了电话通话的压缩效果也一样。
但即便是最好的检测器,也有盲区。AI 模型可以针对某一家克隆公司的工具特征进行调优,但这种能力“往往不能迁移到其他供应商”,Barrington 说。频谱分析(把音频频率随时间的变化可视化)能暴露特定克隆工具的特征,但没有任何单一指标能通吃所有工具。
“你以为能立刻看到破绽,”Barrington 说,“但根本不是这样。”没有哪个单一测量指标能证明一段录音是假的,你需要一整套工具。更麻烦的是,电话通话会压缩或削弱声音的很多关键取证细节,让克隆声音更难被识破。
目前最有前景的防线之一,可能藏在克隆技术本身。一些 AI 音频工具公司,比如 Google,会在生成的音频里嵌入人耳听不见的水印。这个水印在声音里做了细微的改变,人耳察觉不到,但检测器能读出来——而且这个水印会跟着音频文件走,无论被分享到哪里。
水印很强大,但并非万无一失。有人可能通过修改录音来抹掉水印。而且,水印不是强制性的——在一些开源工具里,它只是可选项。不过 Barrington 说,好的水印就像一扇锁上的门,能“挡住 99% 的坏情况”。至于剩下的 1%,我们的音频取证技术只能和克隆工具赛跑,看谁进化得更快。
这件事对开发者意味着什么?如果你在做语音相关的产品——客服系统、语音助手、内容审核——你需要把“声音可能是假的”纳入设计考量。音频取证和水印不是互相替代的关系,而是互补的防线。水印解决“源头可信”的问题,取证解决“事后验证”的问题。另外,电话场景下的检测难度陡增,如果你的业务依赖电话语音,对检测精度的预期要放低。
最后提醒一句:别以为只有名人政要才会被克隆。3 秒的样本,任何人都能拿到——你发在社交媒体上的语音消息、会议录音、甚至视频里的说话声,都可能是素材。技术门槛已经低到不需要任何专业技能,防骗意识才是第一道防火墙。
内容与图片版权归原作者所有 · 原文: https://www.scientificamerican.com/article/how-to-tell-if-a-voice-recording-is-ai-generated/